 400-188-1518
2026 年研发效能度量指南:如何在提升效率的同时保护团队信任
Table of Contents
2026 年研发效能度量指南:如何在提升效率的同时保护团队信任
您的财务总监希望看到一个能证明工程团队高效产出的数据指标,而您的工程师们则担心这个数据会被用来建立排行榜,甚至成为裁员的前奏。这两种担忧都极为合理。大多数度量方案之所以失败,是因为它们只服务于一方的诉求,却疏远了另一方。
本指南提供了一套实用的框架,用于通过 DORA 和 SPACE 模型衡量真实的交付成果,解释了 AI 辅助编程如何改变了“正常”产出基准,并展示了如何在不将度量变为监控手段的前提下开展工作。您还将学会识别何时数字信号实际上指向的是招聘问题,而非流程问题。
1. 2026 年主流研发管理平台推荐概览
在建立度量体系之前,选择一个能够自动采集数据、支持复杂流程配置且具备良好开发者体验的平台是基础。以下是 2026 年值得关注的研发管理平台:
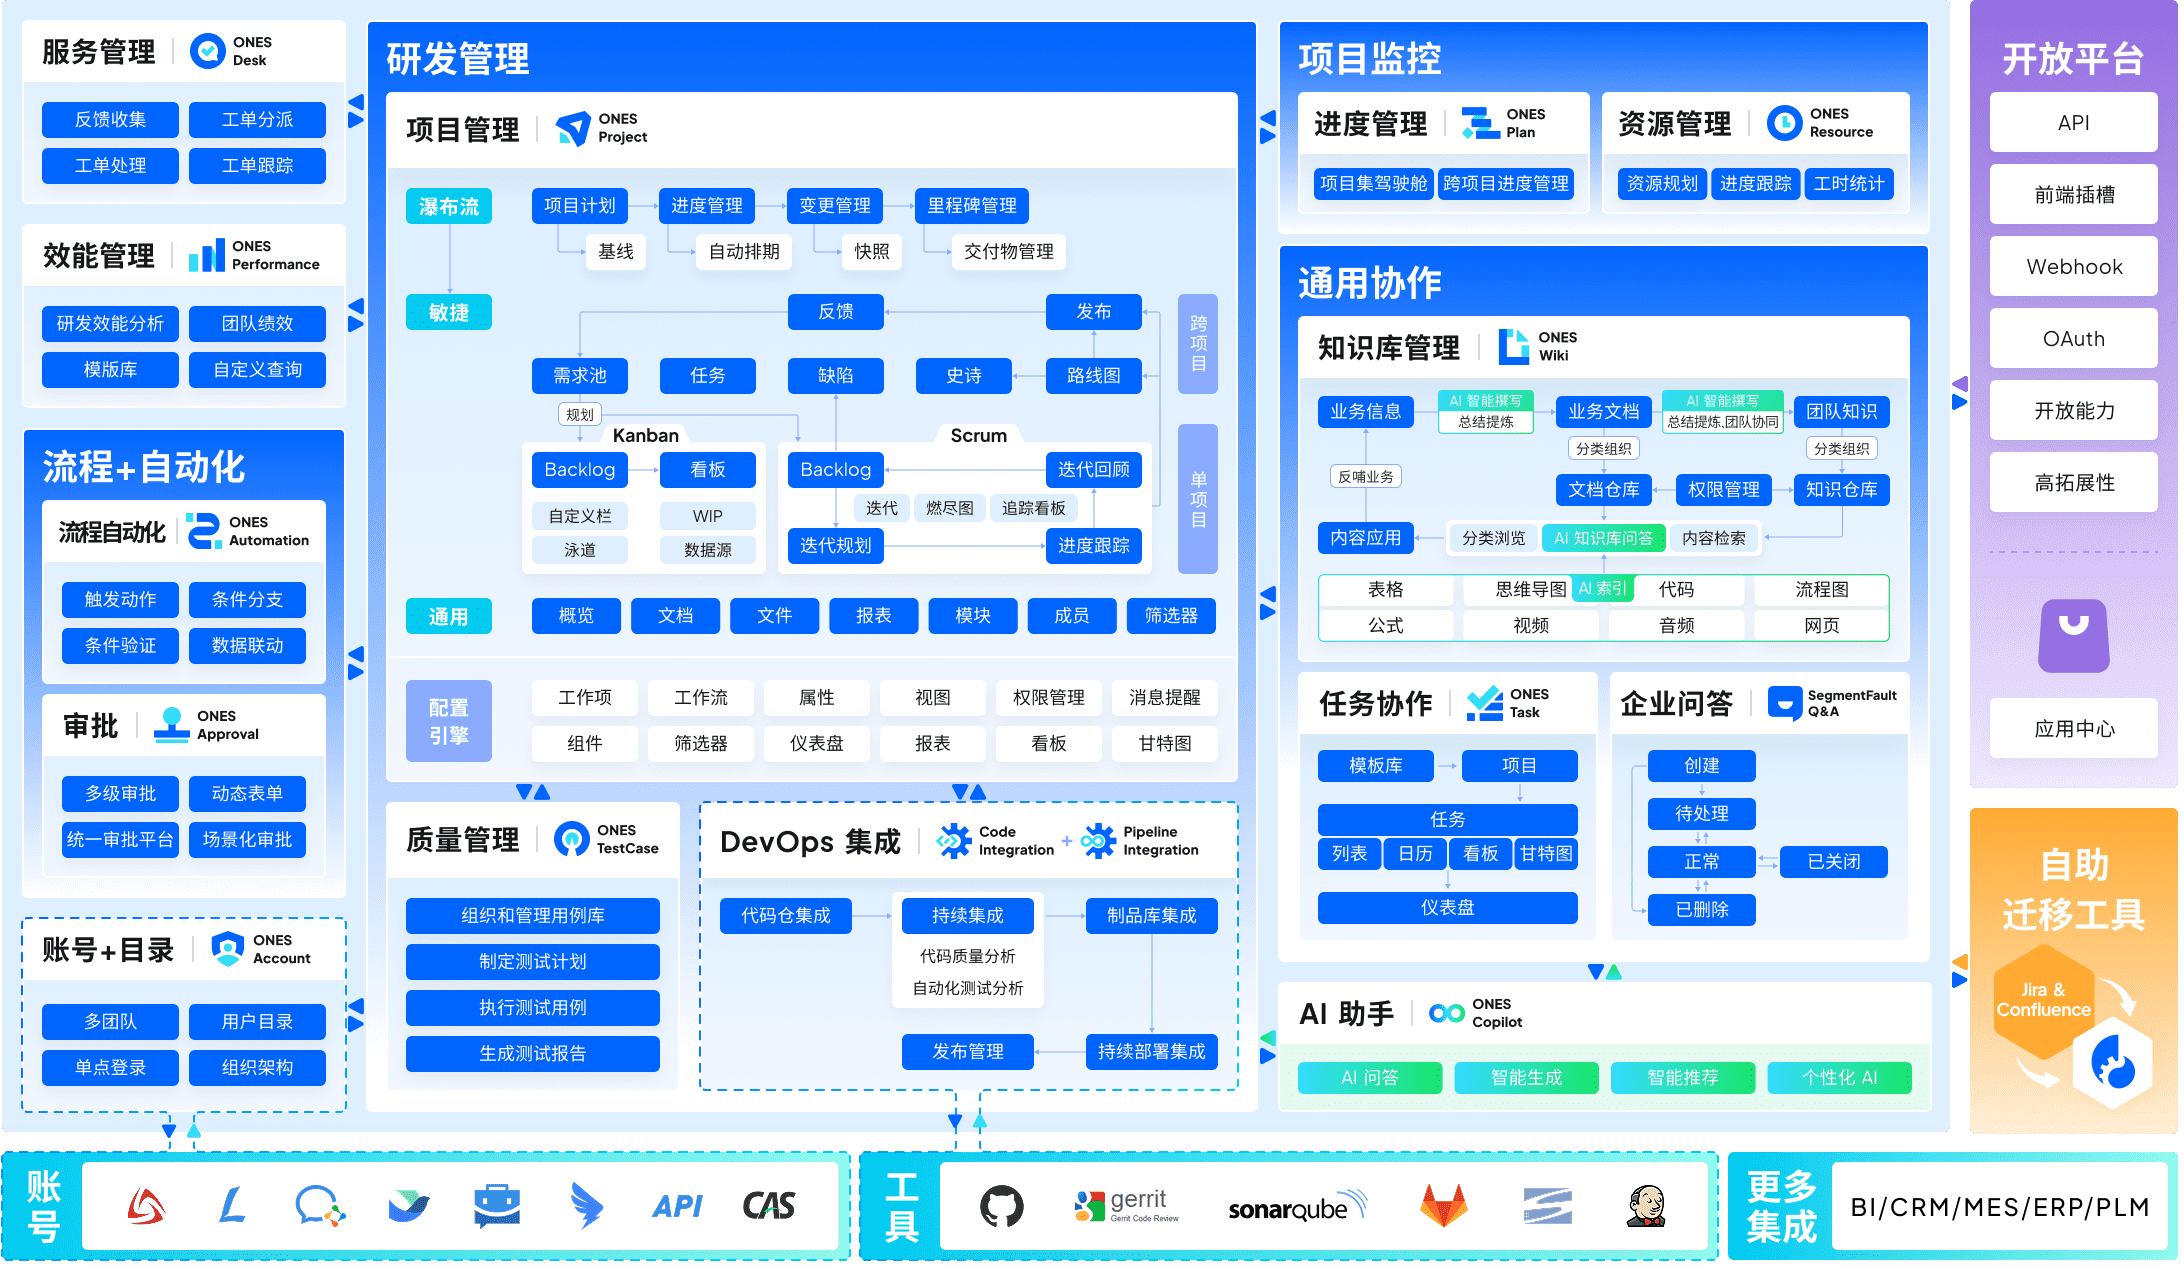
- ONES:企业级研发管理平台,提供从需求到上线的一体化覆盖,支持以数据驱动的研发效能改进。
- LinearB:专注于集成 GitHub、GitLab 和 Jira,自动化呈现 DORA 指标与团队基准对比。
- Jellyfish:擅长将工程指标与业务结果及 R&D 投资报告挂钩,适用于高层汇报场景。
- Swarmia:采用开发者优先理念,强调团队层面的可见性而非个人排名,有助于建立信任。
- DX:由 DX Core 4 研究者开发,结合自动系统指标与开发者调查,生成 DXI 综合评分。
这些工具各有侧重,选择时应基于团队实际信任度与使用习惯,而非仅看技术测量能力。
2. 为什么传统的输出指标在真实工程工作中会失效?
目前仍广泛使用的许多研发效能指标奖励了错误的行为,在 AI 辅助工作流下不堪一击,且使得跨团队比较变得毫无意义。代码行数、提交次数、Pull Request 数量和故事点,每个指标在 2026 年的工程实践中都存在特定的失效模式。
代码行数(LOC)奖励了错误的行为
一位开发人员将 400 行的认证模块重构为 120 行更清晰、更易维护的代码,这实际上提升了系统质量。但如果按代码行数计算,该开发人员在当天的“生产力”为负。代码行数激励的是代码膨胀,而非质量。它惩罚了资深工程师最应该做的工作:简化架构、减少技术债务、提高代码可读性。尽管没有严肃的工程组织会将代码行数作为核心指标,但它仍因看似具体而频繁出现在高管仪表盘中。
提交次数与 PR 数量在 AI 时代的崩坏
GitHub Copilot、Cursor 和 Claude Code 等 AI 编程助手加剧了这一问题。使用 AI 助手的开发人员一天可能生成 15 个小 PR 用于样板代码、测试存根和脚手架搭建,而手动完成同样工作的开发人员可能只产生 3 个。按 PR 数量计算,前者看似生产力高出五倍,但实际交付价值可能相同,甚至可能因 AI 生成代码的质量问题导致下个 Sprint 的重返工。
DORA 2025 年度报告指出,开发者节省下来的代码生成时间常被重新分配至审计和验证环节,而非被消除;更高的 AI 采用率与交付吞吐量和交付不稳定性的增加并存。衡量提交次数而不衡量这些提交做了什么、以及给下游审查带来的负担,只是噪音而非信号。
故事点与工时记录扭曲了跨团队比较
故事点最初设计为团队内部规划工具,而非跨团队生产力基准。背负大量技术债务的团队在处理遗留支付服务时,可能需要消耗 8 个故事点,而使用现代技术栈的团队完成类似功能可能仅需 2 个。比较两者的速度毫无意义。
工时记录更糟糕。它衡量的是在场时间,而非产出。一位开发人员花费六小时解决不稳定的 CI 流水线问题,两小时编码,在“代码编写工时”指标上看起来不如那位本周拥有整洁构建环境的开发人员“高效”。这种指标无法捕捉决定吞吐量的系统性摩擦。
3. 有效的度量应捕捉什么?
优秀的研发效能指标应衡量三个维度:
- 交付速度与可靠性:代码以多快速度、多安全的方式到达生产环境。
- 开发者体验:开发环境是支持还是阻碍了好工作的产生。
- 业务影响:已交付的工作是否推动了客户或收入目标的达成。
没有任何单一指标能覆盖所有维度。结合这三个维度,才是改进研发效能度量而不将仪表盘变为对立面记分牌的关键。这正是 DORA 和 SPACE 模型共存的原因,它们互为补充,而非替代关系。
4. 使用 DORA 追踪交付速度与可靠性
DORA 指标(由 DevOps 研究与评估团队开发,现隶属于 Google)是衡量软件交付性能的行业标准。四大核心指标描述了团队将代码推送到生产环境的速度与可靠性。它们有效的原因是衡量系统级结果,而非个人活动,从而反映部署流水线、审查流程和事件响应的健康状况。
注意:DORA 2025 年报告已不再严格使用“精英/高/中/低”层级系统,转而采用百分位区间。下表中的“顶级表现者”范围参考了近期报告中的常见引用值,应视为方向性目标,而非认证测试标准。
| 指标 | 衡量内容 | 顶级表现者范围 | 常见误读 |
|---|---|---|---|
| 部署频率 | 代码到达生产的频率 | 按需(每天多次) | 将高频等同于高质量 |
| 变更前置时间 | 从提交到生产的时长 | 低于一天 | 忽视代码审查中的排队时间 |
| 变更失败率 | 导致事件的部署百分比 | 约 5% 或更低(部分报告上限为 15%) | 因部署更多而惩罚团队 |
| 服务恢复时间 | 从失败部署中恢复所需时间 | 低于一小时 | 混淆快速恢复与较少事件 |
4.1 部署频率 (Deployment Frequency)
追踪团队将代码推送到生产的频率。顶级团队按需部署,通常每天多次。每周或更少部署的团队通常存在手动发布流程、大批次发布或测试覆盖不足导致的小批量发布信心缺乏。
数据获取:查询 CI/CD 平台(GitHub Actions, GitLab CI, Jenkins)的成功生产部署次数,过滤掉 staging 或 dev 环境部署。
常见误读:高部署频率并非 inherently 好。一天内部署十次 broken code 的团队拥有高频但极差的交付性能。务必结合变更失败率阅读部署频率。
4.2 变更前置时间 (Lead Time for Changes)
测量从开发人员第一次提交到代码在生产环境运行之间的时间。它涵盖了编码时间、代码审查等待时间、CI 流水线持续时间和部署队列时间。
数据获取:跟踪分支上的第一次提交时间戳直至生产环境部署时间戳。与 GitHub 链接的 Jira 等工具可自动化此过程。
4.3 变更失败率 (Change Failure Rate)
导致生产事件、回滚或热修复的部署百分比。上升的变更失败率通常信号测试覆盖不足、审查匆忙或 AI 生成代码未经充分审查即通过。
数据获取:将失败部署数(需回滚、热修复或事件响应)除以同期总部署数。从业主工具(PagerDuty, Opsgenie)获取事件数据并与部署时间戳关联。
4.4 服务恢复时间 (Time to Restore Service)
又称 MTTR,测量团队从失败部署或生产事件中恢复的速度。顶级团队在一小时内恢复。该指标反映事件响应成熟度、运行手册质量和系统可观测性。
数据获取:测量事件管理平台中从事件创建到解决的时间跨度。
5. 加入 SPACE 模型:避免忽视倦怠、摩擦与隐性工作
DORA 告诉您交付系统的表现,但未告知团队是否以牺牲健康为代价达成这些数字。SPACE 模型(由包括 Nicole Forsgren 在内的研究人员开发)捕捉了吞吐量指标所隐藏的人性化和协作维度。
场景假设:一个团队连续两个季度发布强劲的 DORA 数据。部署频率高,前置时间低于一天,变更失败率低。从交付指标看,他们表现卓越。但在这些数字背后,三名高级工程师承担 80% 的 on-call 负荷,审查压力导致两名成员正在面试其他机会,且团队存在未被量化的隐性协作成本。
SPACE 模型通过五个维度弥补这一空白:
- Success (成功):团队如何定义和衡量工作成果的质量。
- Performance (性能):任务完成的速度和效率。
- Activity (活动):完成工作所需的行为(如编码、测试)。
- Communication (沟通):协作和信息共享的有效性。
- Efficiency (效率):减少摩擦和浪费的程度。
在 2026 年,结合 DORA(系统结果)与 SPACE(人的体验),才能全面评估研发效能。
6. AI 辅助编程工具如何重置基准?
AI 不再仅仅是效率倍增器,它正在改变“正常”产出的定义。DORA 2025 报告明确指出,AI 的引入使得代码生成速度大幅提升,但同时也带来了新的验证负担。管理者需调整预期,不再单纯追求代码行数或 PR 数量,而是关注 AI 辅助下代码的准确性、审查效率以及最终交付的业务价值。
7. 破坏团队信任的常见度量误区
- 个人排名化:将团队指标强行分解到个人,引发内部竞争而非协作。
- 单一指标决策:仅凭部署频率或代码行数进行绩效考核,忽视业务上下文。
- 忽视隐性工作:未将架构设计、文档编写、知识分享和 mentorship 纳入考量。
- 数据孤岛:工具间数据不通,导致度量数据滞后或不准确,引发工程师对工具本身的不信任。
8. 构建一个团队愿意信任的度量系统
要建立可信的度量系统,需遵循以下步骤:
- 明确目标:度量是为了改进流程,而非监控个人。与团队共同制定度量目标。
- 选择合适工具:使用如 ONES 这样的平台,它提供一体化覆盖,从需求管理到流水线监控,减少工具割裂,确保数据一致性。
- 聚合数据:结合 DORA 与 SPACE 指标,形成多维视图。
- 定期回顾:与团队共同审查度量数据,讨论改进点,而非直接下达指令。
- 透明化:向团队公开度量方法和数据来源,消除黑盒疑虑。
9. 实践决策矩阵:人员、流程与平台变更
当数据出现异常时,参考以下矩阵判断根本原因:
| 现象 | 可能原因 | 建议行动 |
|---|---|---|
| 部署频率低,变更失败率高 | 测试覆盖不足,发布流程手动 | 优化 CI/CD 流水线,增加自动化测试 |
| 变更前置时间长 | 代码审查瓶颈,任务切换频繁 | 限制 WIP,优化审查流程,使用工具自动提醒 |
| 开发者满意度低 (SPACE) | 工具链复杂,上下文切换多 | 引入一体化平台(如 ONES),简化工具链 |
| 跨团队比较显示某团队“低效” | 技术债务差异,业务复杂度不同 | 避免跨团队直接比较,关注团队自身趋势 |
10. 何时数据指向招聘问题而非流程问题?
如果团队流程成熟、工具先进,但关键任务交付仍严重滞后,且资深工程师过度负荷,这可能指向技能缺口或人员配置不足。此时,度量数据应触发招聘或培训决策,而非进一步的压力测试。
常见问题 (FAQ)
Q1: 2026 年,AI 是否会取代研发效能度量?
A: 不会。AI 改变了工作方式和产出基准,但人类对效率、质量和协作的需求未变。度量框架需适应 AI 带来的变化,如增加对代码验证和 AI 生成代码质量的评估,而非被取代。
Q2: 如何向 CFO 证明研发效能提升?
A: 使用如 Jellyfish 或 ONES 等平台,将 DORA 指标与业务结果(如客户留存、收入增长)关联,展示工程投入如何直接驱动商业成功。
Q3: 选择研发管理平台时,最应关注什么?
A: 关注平台是否能一体化覆盖研发全流程,减少工具割裂;是否支持复杂权限与流程配置以适配中大型组织;以及是否具备强大的数据度量能力,帮助团队以数据驱动改进。
Q4: 如何平衡监控与信任?
A: 坚持团队级度量而非个人级;公开度量标准与数据来源;将度量结果用于流程改进而非绩效考核;重视 SPACE 指标中的开发者体验。