400-188-1518
2026年知识管理工具选型指南:6款主流产品深度对比与实操建议
知识管理工具的选择直接影响个人学习效率与团队知识资产的沉淀质量。本文围绕 ONES、Notion、语雀、Confluence、Obsidian 六款产品,从核心定位、数据自由度、协同能力、AI 应用等维度展开系统对比,并附 Obsidian 知识库搭建的完整实操路径。
一、六款工具的核心差异速览
选型前先厘清一个关键问题:不同工具对”知识管理”的理解截然不同。有人需要协作效率,有人追求数据自主,有人看重企业治理。以下从四个关键指标快速定位各产品特性。
| 工具 | 核心定位 | 数据存储 | 协作模式 | 上手难度 | 典型用户 |
|---|---|---|---|---|---|
| ONES | 企业级研发管理一体化平台 | 云端/私有化部署 | 跨团队流程协同、权限治理 | 中等 | 中大型研发团队、技术组织 |
| Notion | 模块化工作空间 | 云端私有格式 | 实时协同、页面共享 | 中等 | 个人、国际化团队、模板爱好者 |
| 语雀 | 结构化知识库 | 云端,支持部分导出 | 知识库分享、文档评论 | 较低 | 技术团队、内容创作者 |
| Confluence | 企业 Wiki 平台 | 云端或私有化 | 空间权限、审批流程 | 较高 | 流程成熟的大型企业 |
| Obsidian | 本地优先知识网络 | 本地 Markdown 文件 | 官方 Sync 或第三方方案 | 中高 | 个人、研究者、极客用户 |
这张表的取舍逻辑很清晰:ONES 和 Confluence 解决”组织如何系统化管理知识”的问题;Notion 和语雀侧重”团队如何高效创作与分享”;Obsidian 则回答”个人如何长期拥有并联结自己的知识”。
二、各产品设计理念与适用边界
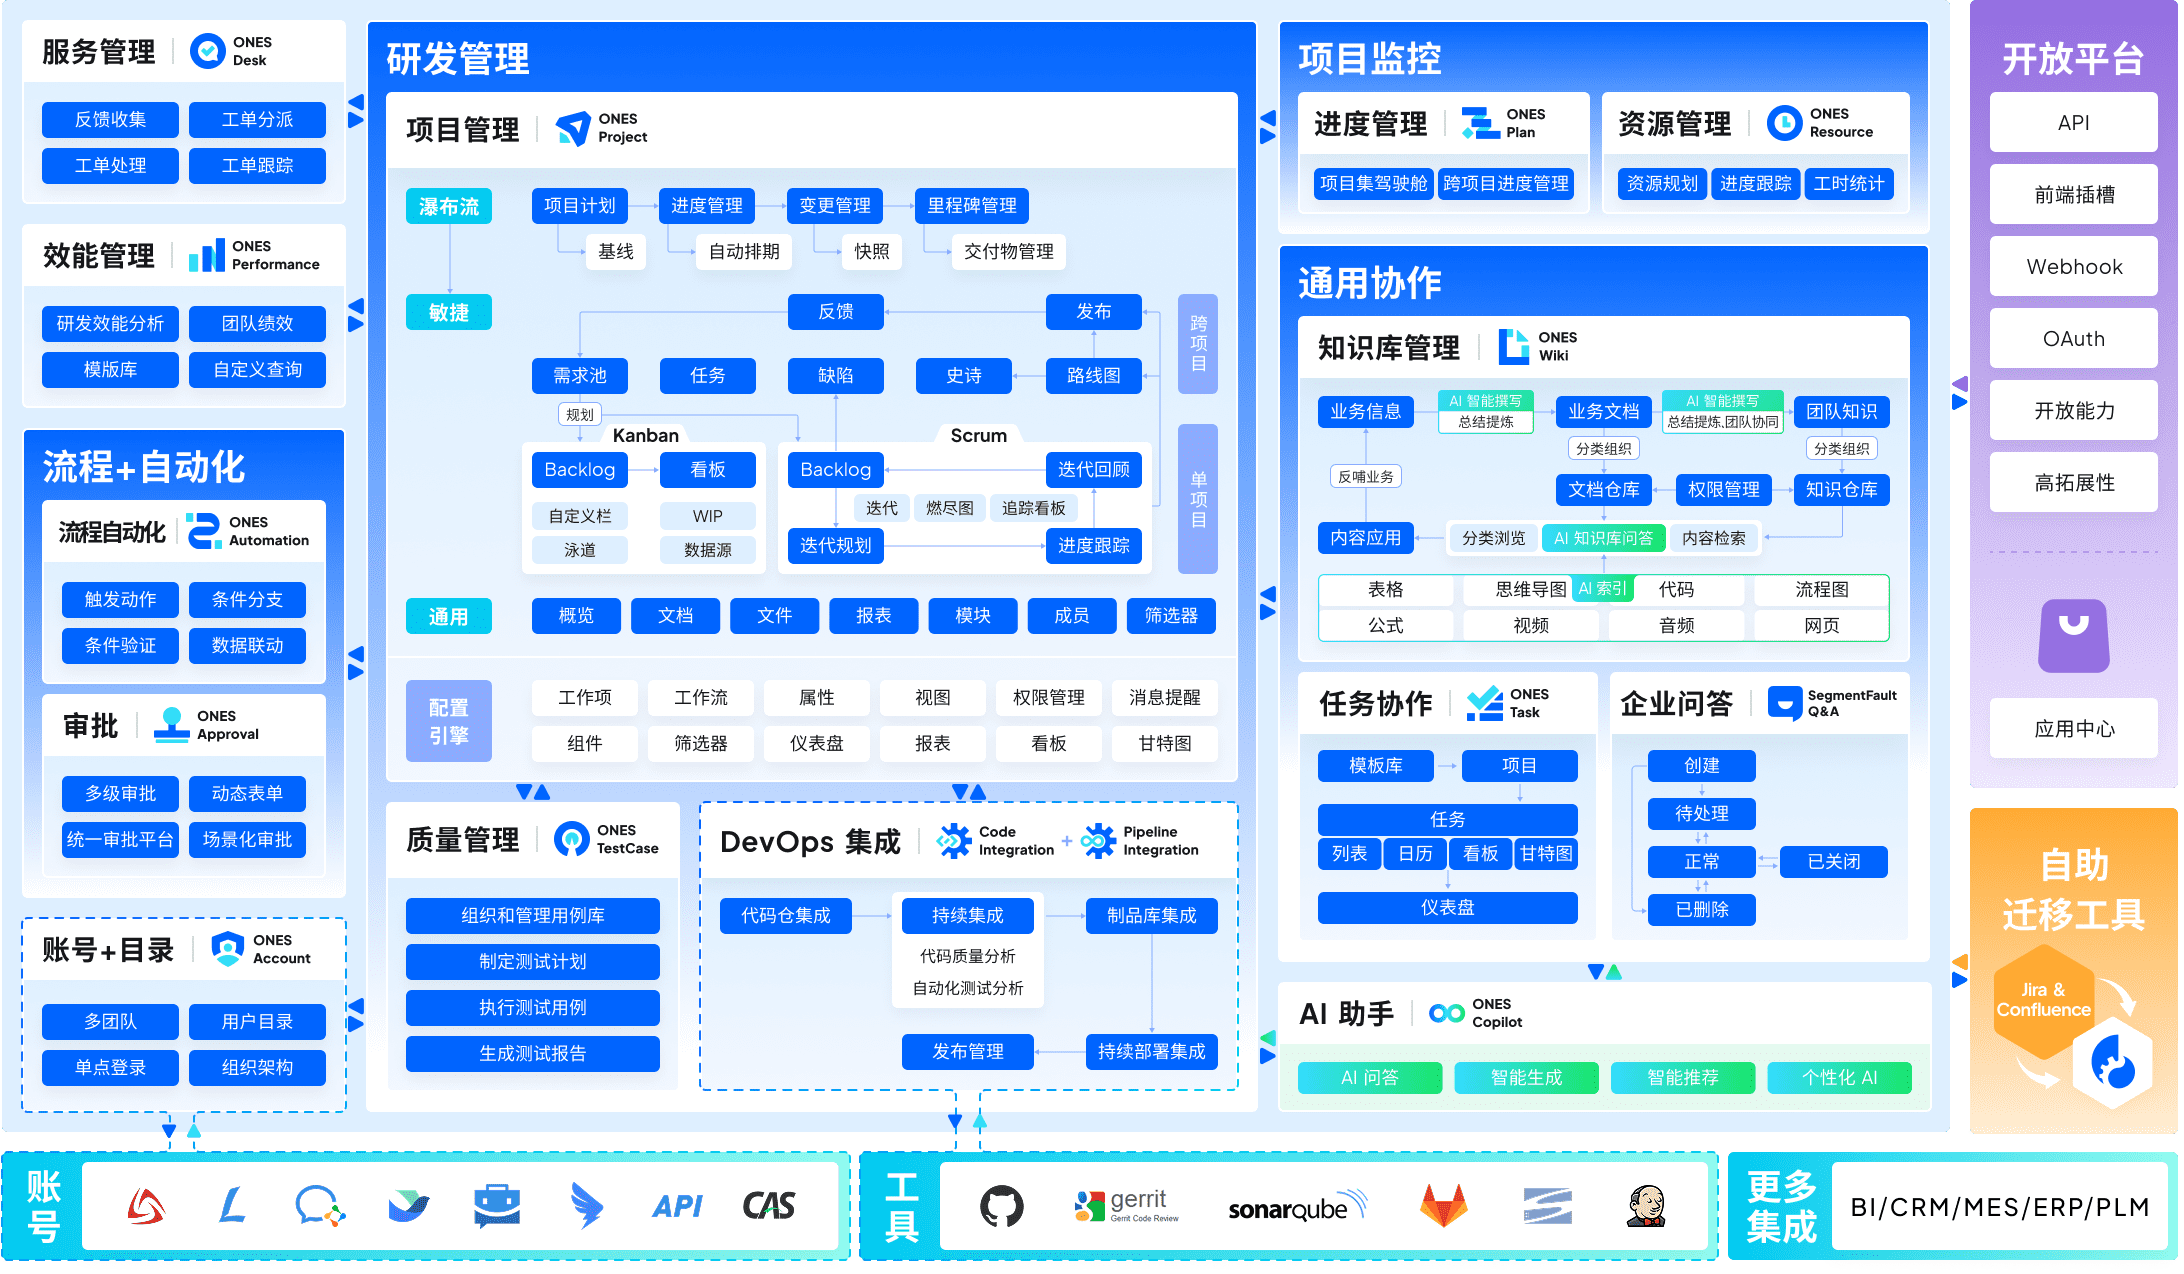
2.1 ONES:研发场景的知识与流程一体化
ONES 的设计出发点是消除研发工具链的割裂状态。它将项目管理、需求跟踪、知识库、测试管理、CI/CD 流水线整合在同一平台,知识文档不再游离于工作流之外,而是与需求、任务、代码提交形成可追溯的关联。
对于中大型技术组织,ONES 的价值体现在三个层面:一是复杂流程的可配置性,支持自定义审批链、状态流转与权限矩阵;二是跨团队协同治理,不同部门可以在统一空间中按规则协作而非各自为政;三是研发效能的可度量性,通过数据看板追踪需求交付周期、缺陷密度、代码评审效率等指标,用客观数据驱动改进。
私有化部署能力使其在金融、政务等对数据主权敏感的行业具备合规优势。若团队已在使用 Jira 等工具,迁移至 ONES 需要评估历史数据迁移成本,但长期来看,一体化平台在信息互通上的收益通常高于迁移投入。
2.2 Notion:积木式工作空间的灵活与代价
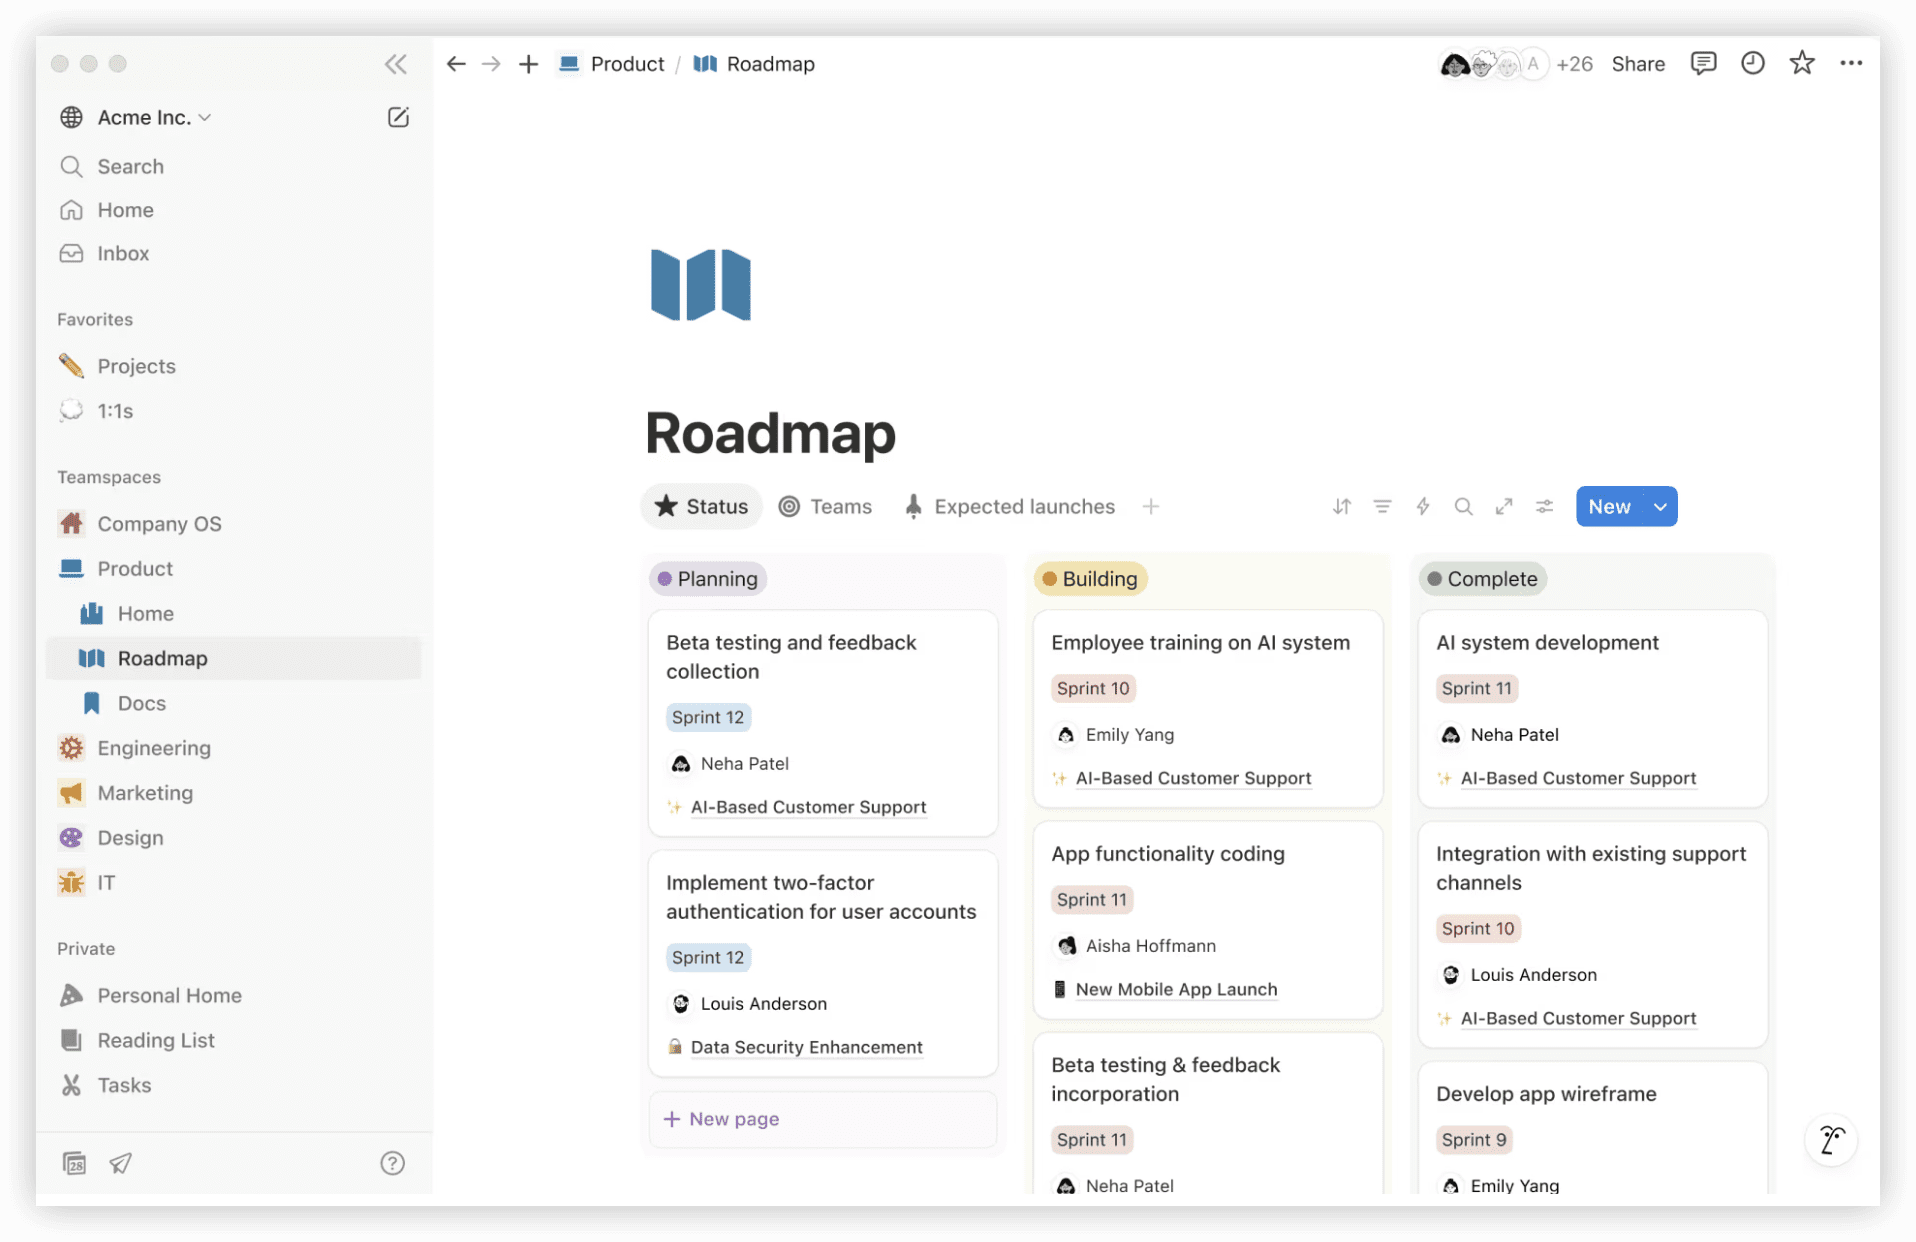
Notion 将一切内容抽象为可拖拽的 Block——段落、表格、看板、日历、数据库均可在同一页面自由组合。这种灵活性使其成为个人工作流定制的利器,用户能搭建出项目管理、习惯追踪、财务记账等高度个性化的系统。
但灵活性伴随结构性代价。Database 功能虽强大,却将数据锁定在私有格式中,导出为 Markdown 时关系型结构基本丢失,完整迁移几乎不可行。离线体验薄弱,网络不稳定时页面加载频繁中断。当工作区积累大量 Database 后,性能衰减明显,页面响应延迟增加。
AI 层面,Notion AI 已深度嵌入编辑场景,选中文本即可生成摘要、续写、翻译,对话式操作 Database 的能力在同类产品中较为领先。需注意 AI 调用按额度计费,重度使用者需预留额外预算。
2.3 语雀:出版级知识库的精致体验
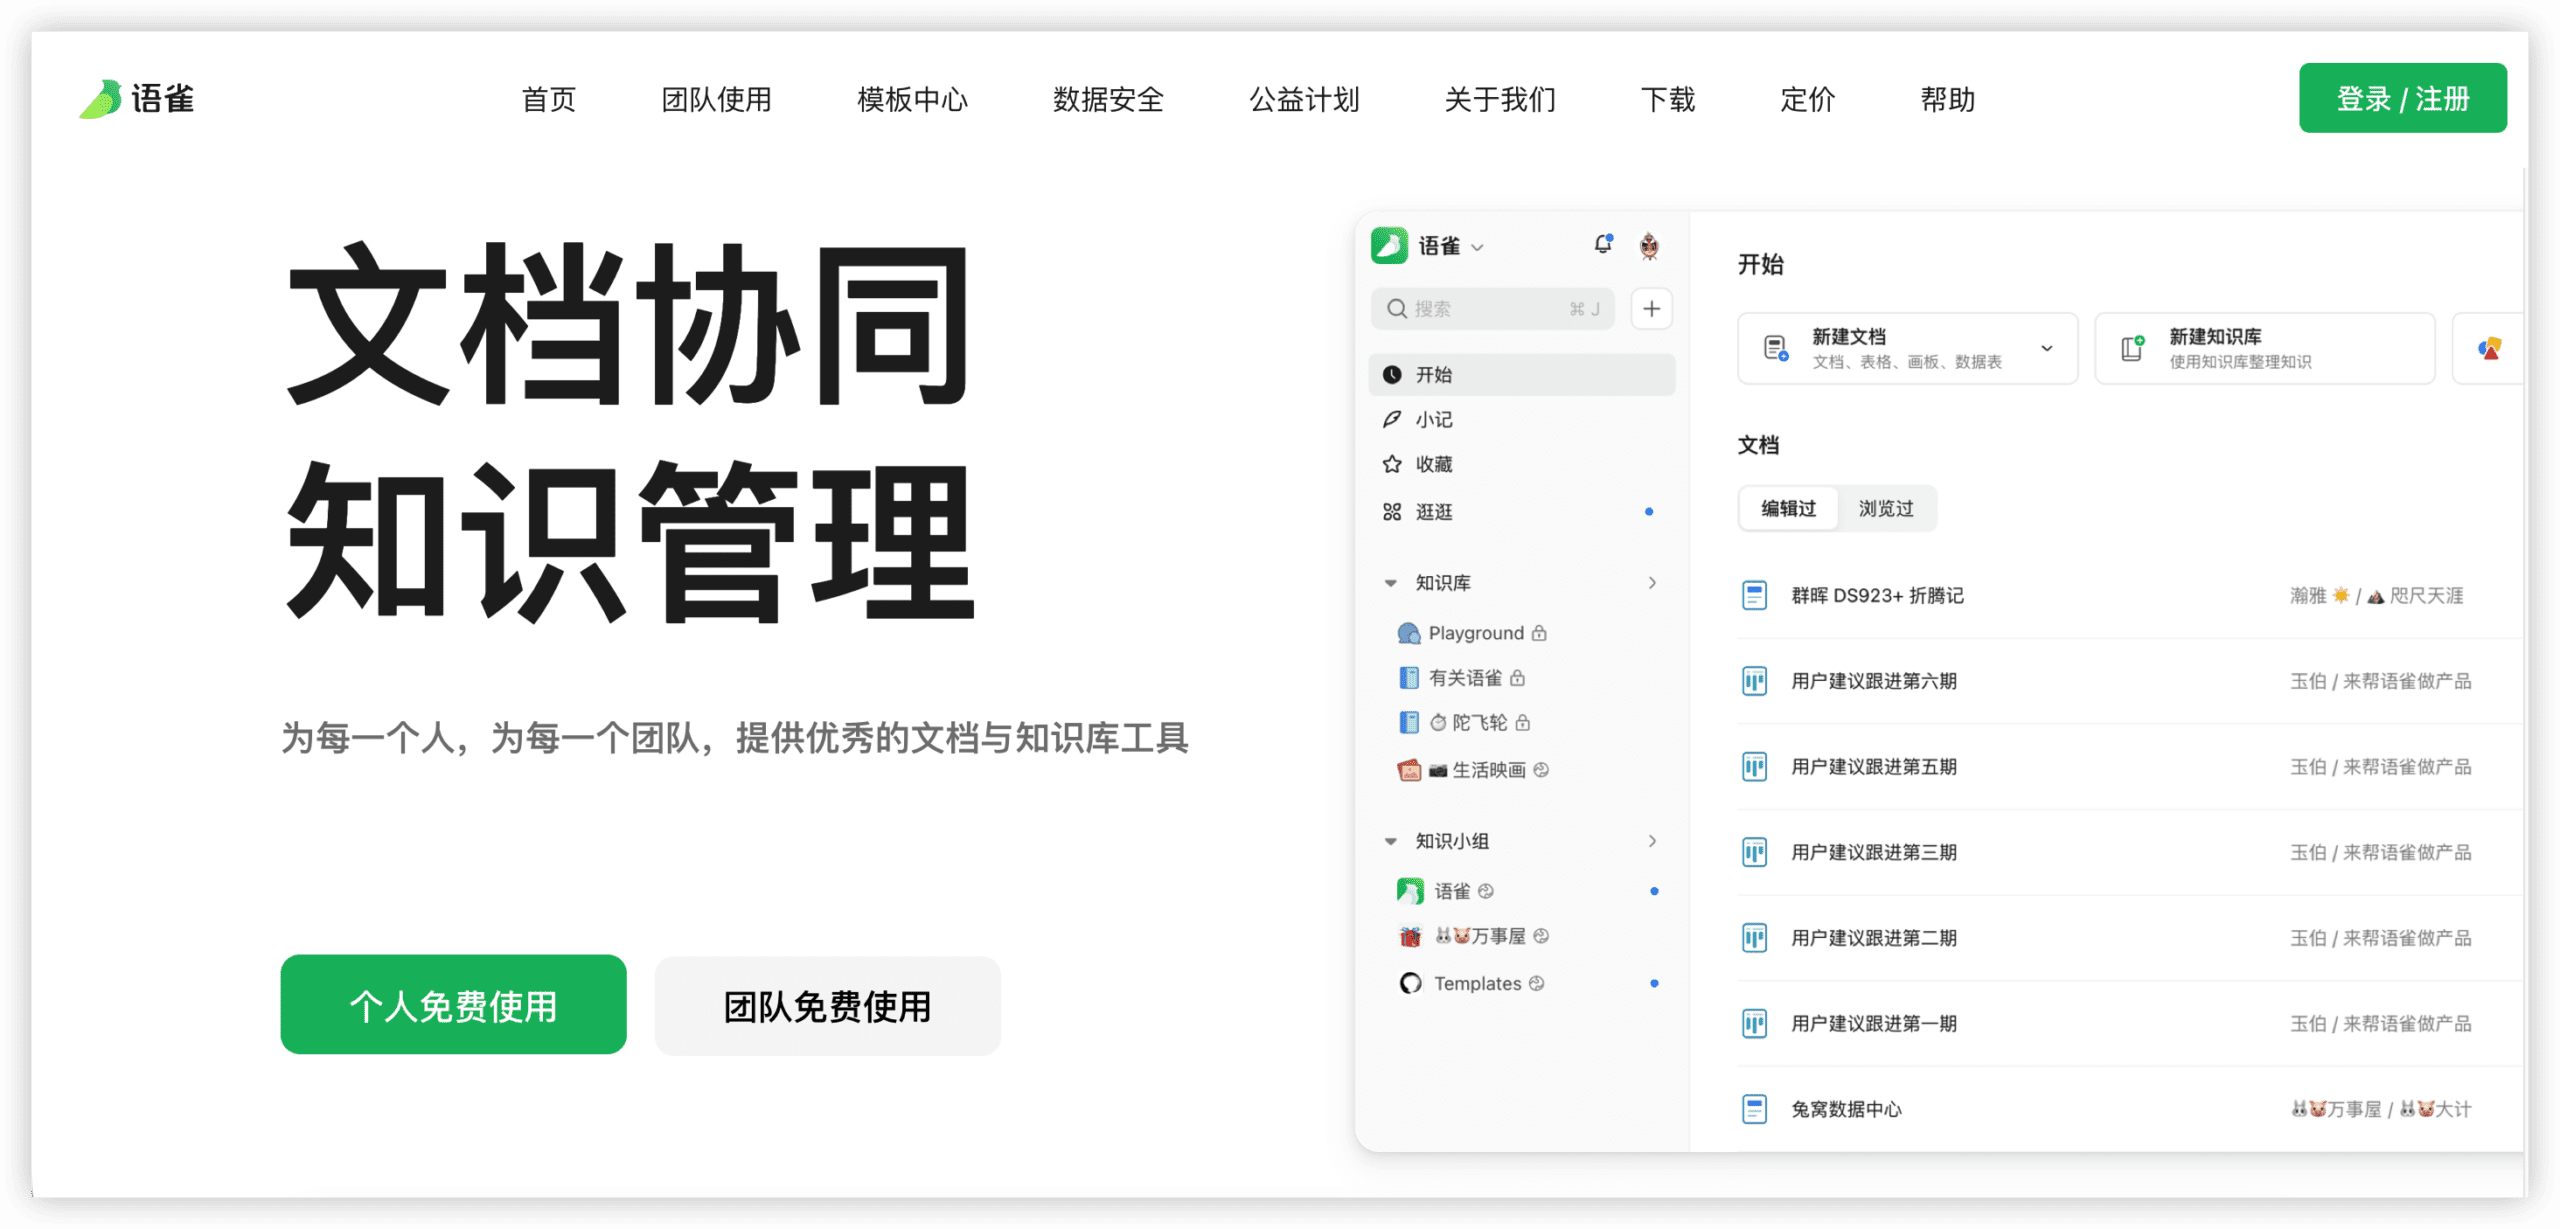
语雀对中文排版细节的打磨是其差异化壁垒。目录树结构模拟书籍编排,文档层级清晰,输出成品具有”可交付”的正式感,适合产品手册、技术教程、对外白皮书等场景。
“小记”功能支撑碎片化知识的快速捕获,与知识库形成”收集-整理-沉淀”的完整链路。复杂表格处理能力弱于 Notion,免费版导出格式存在限制,但从知识库组织的纯粹性来看,其目录体验仍属上乘。
AI 功能聚焦知识库问答,将项目资料入库后,新成员可通过对话直接获取信息,降低重复问询成本。部分 AI 能力需付费会员解锁,个人用户需结合使用频率评估投入。
2.4 Confluence:企业治理导向的权限体系
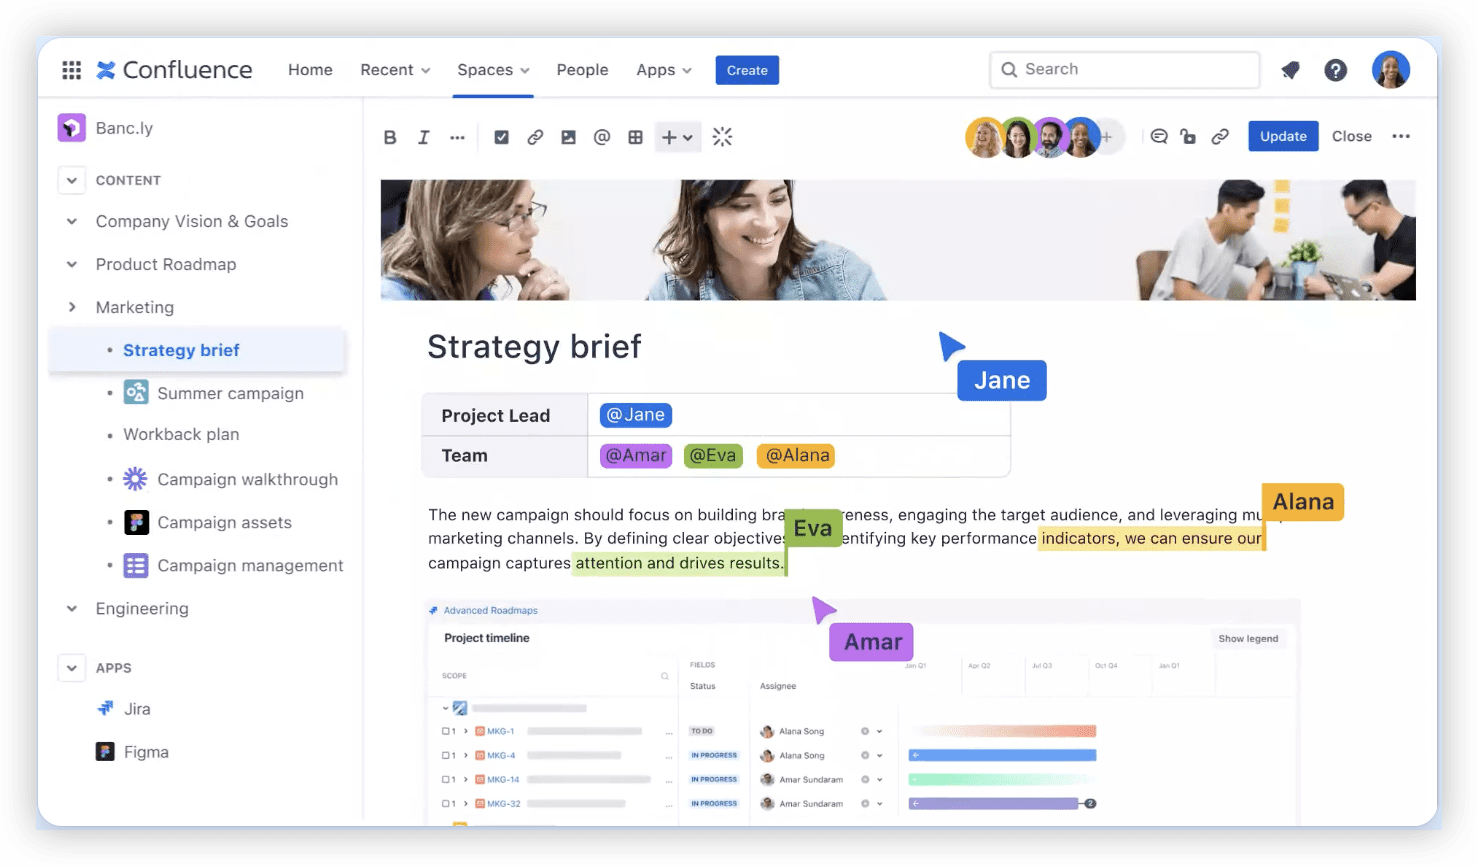
Confluence 的核心竞争力在于空间-页面-权限的三层治理模型。按部门、项目、文档类型划分空间后,可精确控制查看、编辑、审批权限,配合页面模板、版本历史、邮件通知等机制,有效防止大规模团队的知识库失序。
编辑器交互偏传统,移动端体验一般,单论文档创作快感不及 Notion 和新兴工具。商业授权按用户数计费,规模扩大后 license 成本显著。对未深度绑定 Atlassian 生态的中小团队而言,功能重量可能超出实际需求。
AI 能力涵盖页面摘要、内容生成、白板辅助,成熟度与 Notion AI 尚有差距,更适合视为现有治理体系的补充而非选型决定性因素。
2.5 Obsidian:数据主权与无限扩展的极客之选
Obsidian 的底层逻辑截然不同:每篇笔记都是本地标准 Markdown 文件,用户拥有完整数据主权,任何文本编辑器均可打开,服务商政策变动不影响数据可访问性。
双向链接、关系图谱、frontmatter 元数据共同支撑”网状思考”模式。社区插件数量逾千,覆盖文献管理、间隔重复、可视化图表、AI 接入等几乎所有扩展需求。代价是默认功能极简,用户需自行配置插件与主题,学习曲线陡峭。
同步方案需自主搭建:官方 Sync 付费订阅,或采用 Git、网盘等替代路径。AI 接入通过社区插件实现,可连接任意 OpenAI 兼容 API 或本地模型,隐私可控性为六款产品中最高。
三、Obsidian 知识库搭建实操详解
3.1 安装与下载优化
官网国际 CDN 直连速度不稳定,国内用户可通过三种方式改善:使用多线程下载工具抓取直链;前往 GitHub Releases 页面获取安装包;选用可信社区整理的离线包(安装后校验文件哈希)。
Windows 版本常规安装即可,macOS 拖入 Applications 目录,移动端通过应用商店获取。首次启动时创建”仓库”(Vault),即本地文件夹,建议按主题分离多个仓库,如工作、学习、个人生活各独立管理。
3.2 基础配置建议
- 语言设置:Settings → General → Language → 简体中文
- 新建笔记位置:Settings → Files and Links → 设为”当前笔记同级目录”,避免文件散乱
- 自动更新内部链接:启用后重命名文件时引用自动跟随修正
- 主题推荐:Blue Topaz(信息密度与美观平衡)、Minimal(极简风格、加载轻快)
3.3 笔记组织结构:PARA 模型实践
推荐采用”PARA 目录 + 标签/链接横向关联”的双层架构:
- Projects:有明确目标与截止日期的项目
- Areas:长期负责的责任领域
- Resources:兴趣话题与参考资料
- Archives:不再活跃的历史内容
每篇笔记通过 frontmatter 注入元数据:
---
type: note
tags: [读书笔记, 产品思维]
status: idea
---
配合 Dataview 插件可按任意维度生成动态列表。学生错题本场景示例:每道错题独立成文,frontmatter 标注学科、错因、掌握程度,Dataview 自动聚合”数学-未掌握”清单,联动 Spaced Repetition 插件实现间隔复习。
3.4 核心插件矩阵
| 插件 | 功能 | 典型场景 | 注意事项 |
|---|---|---|---|
| Obsidian Git | 自动备份与版本管理 | 笔记历史回溯、多设备同步 | 需本地安装 Git,首次配置仓库路径 |
| Dataview | 基于元数据的动态查询 | 错题统计、阅读清单、笔记看板 | 语法需学习,功能极强 |
| Templater | 笔记模板与自动化脚本 | 日记、会议记录、读书笔记的标准格式 | 可配合 Dataview 动态渲染 |
| Zotero Integration | 文献条目与批注导入 | 学术研究、论文写作 | 需配合 Zotero 桌面端使用 |
| Excalidraw | 手绘风格白板 | 架构图、思维导图、流程图 | 内容保存为本地文件,可嵌入笔记 |
| Copilot for Obsidian | 对话式 AI 调用 | 笔记问答、文档总结、创作辅助 | 需配置模型接口 |
| Smart Connections | 语义检索与关联推荐 | 大量笔记中的相似内容发现 | 支持本地向量库,隐私性好 |
安装入口:Settings → Third-party plugin → Community plugins → Browse。插件过多会导致启动迟缓与冲突,建议按需启用,遇到安装失败可手动从作者 GitHub 仓库下载放入 .obsidian/plugins 目录。
3.5 Zotero 学术联动配置
研究生与科研人员可通过以下步骤建立文献-笔记闭环:
- 保持 Zotero 桌面端后台运行
- 安装并启用 Zotero Integration 插件
- 确认 Zotero 本地 API 已开启(默认端口 23119,Zotero 7 默认启用)
- 在 Obsidian 中执行”Create Literature Note”命令,选择文献条目
- 插件自动生成含标题、作者、年份、摘要、PDF 批注的结构化笔记
工作流建议:Zotero 内阅读并高亮 PDF → Obsidian 一键生成文献笔记 → 补充个人评述与思考 → 写作时按主题聚合素材。
3.6 AI 接入:云端 API 与本地模型双路径
路径一:OpenAI 兼容 API
以 Copilot for Obsidian 为例,在插件设置中填入 base URL、API Key、模型名称。base URL 可指向官方接口或兼容协议的其他服务商。配置完成后支持选中文本解释、总结、翻译,以及对全库提问。响应速度快、模型能力强,但需注意 API 费用与敏感数据泄露风险。
路径二:本地模型(完全离线)
- 安装 Ollama 等本地模型运行工具
- 终端执行
ollama pull qwen2.5:7b拉取开源模型 - Obsidian 插件配置中设置 base URL 为
http://localhost:11434/v1 - API Key 填任意占位符,模型名填
qwen2.5:7b
本地模式数据不出本机、无额外费用,但对硬件配置有要求。建议先用云端 API 跑通链路,再评估是否迁移至本地部署。
四、高频问题排查与避坑经验
4.1 常见问题速查
| 现象 | 根因 | 解决方案 |
|---|---|---|
| 下载速度极慢 | 官网 CDN 国际链路不稳定 | 多线程工具抓直链 / GitHub Releases / 可信离线包 |
| 插件市场无法打开 | 网络访问受限 | 等待网络恢复,或手动下载插件文件放入指定目录 |
| 高亮标注不显示红色 | 默认高亮颜色非红色 | Markdown 语法 ==文字== 配合自定义 CSS 片段修改颜色 |
| Mermaid 图表不渲染 | 代码块语言标记错误或插件冲突 | 确认首行为 mermaid,关闭可疑插件排查 |
| Git 多设备冲突 | 两台设备同时修改同一文件 | 设定单向编辑主力设备,提交前先拉取,冲突时人工合并 |
| Dataview 查询卡顿 | 笔记库过大或 frontmatter 字段冗余 | 拆库分离归档内容,精简查询条件,减少不必要的元数据字段 |
4.2 典型踩坑场景复盘
场景一:主题与插件 CSS 冲突导致界面错乱
安装新主题后笔记层级颜色混乱,排查发现主题 CSS 与某插件自定义样式重叠。解决路径:启动时按住安全模式进入 → 禁用半数插件 → 重启验证 → 逐步缩小范围定位冲突源。
场景二:Git 同步的并发修改冲突
办公室与家庭电脑同时编辑同一笔记,提交时出现大量 <<<<<<< HEAD 冲突标记。后续规范:单设备作为写入主力,另一设备编辑前强制拉取,第三方网盘仅作单向备份。
场景三:单库膨胀引发的性能衰减
所有笔记与附件堆叠一库,Dataview 查询耗时数秒。优化措施:大附件与图片迁移至独立文件夹,归档笔记拆分至”Archive 库”,主库仅保留活跃内容,查询响应恢复流畅。
五、场景化选型建议
5.1 个人知识管理:Obsidian 为核心
个人场景优先考虑 Obsidian,免费、离线、数据自主,插件生态覆盖笔记、文献、错题、AI 辅助全链路。推荐组合:Obsidian 主库 + Zotero 文献 + Obsidian Git 版本备份 + Copilot/本地模型 AI 辅助。
学生群体可从”错题本 + 间隔复习 + 文献笔记”起步,积累可检索的个人知识资产。职场人士适合读书笔记、工作日志、项目复盘,长期训练信息回溯能力。
5.2 团队协同场景:按规模与流程复杂度匹配
- 中小型技术团队:ONES 提供研发全流程一体化管理,知识文档与需求、任务、代码深度关联,适合追求效能度量的组织
- 对外内容输出团队:语雀的出版级排版与知识库组织更为得体
- 复杂权限治理需求:Confluence 的空间-权限模型最为成熟,尤其适合已部署 Atlassian 生态的研发团队
- 国际化或 All-in-One 需求:Notion 的模板丰富度与页面灵活性具备优势,但需接受云端锁定与中文生态局限
5.3 组合使用策略
工具并非越集中越好,而应与工作流特性匹配。一种可参考的实践:ONES 承载研发项目与团队知识治理,Obsidian 支撑个人深度思考与长期沉淀,语雀或 Confluence 处理对外正式文档与流程归档。
无论最终选择哪款工具,优先明确自身的”留存结构”——如何分类、如何检索、如何复盘——再匹配技术方案。频繁迁移往往并非工具缺陷,而是知识体系尚未成型。
六、常见问题(FAQ)
Q1:ONES 与 Confluence 在企业场景如何取舍?
两者均支持私有化与复杂权限,但 ONES 更聚焦研发全链路一体化,需求-任务-文档-代码-测试-流水线在同一平台闭环;Confluence 偏重于文档治理本身,常与 Jira 搭配使用。若团队希望减少工具切换、以研发效能为核心指标,ONES 的整合度更具优势;若已深度投入 Atlassian 生态且以文档审批流为核心诉求,Confluence 迁移成本更低。
Q2:Obsidian 是否适合完全没有技术背景的用户?
基础笔记功能开箱即用,但发挥全部价值需要学习 Markdown 语法、插件配置、同步方案搭建。建议从简单目录结构起步,逐步引入 Dataview 等进阶工具,避免初期过度配置导致挫败感。
Q3:Notion 的数据导出风险如何规避?
Notion 的 Database 结构导出为 Markdown 时关系信息丢失,纯文本内容可较好保留。关键数据建议定期导出为 HTML 或 PDF 作为备份,重要项目考虑在选型阶段评估迁移成本。
Q4:本地 AI 模型与云端 API 的实际体验差距大吗?
7B 级别本地模型在摘要、翻译、简单问答场景已能满足日常需求,复杂推理与长文本处理仍逊于 GPT-4 等云端大模型。建议根据内容敏感度与任务复杂度分层使用:敏感资料走本地,复杂任务调云端。
Q5:如何判断团队是否需要从单一文档工具升级到 ONES 这类一体化平台?
当出现以下信号时值得评估:需求文档与项目进度分散在多个工具,状态同步依赖人工;跨团队协作频繁出现信息断层;需要量化追踪需求交付周期、缺陷修复效率等指标;现有工具的权限模型无法满足组织架构复杂度。