 400-188-1518
2026 年 AI 知识库工具全景指南:六类场景与选型路径
构建 AI 知识库需要匹配正确的工具类型。本文梳理六类主流方案,涵盖 ONES、Obsidian、Mem0、Dify、RAGFlow 等 14 款代表性产品,按场景分赛道对比,并提供可直接落地的选型决策树。
Table of Contents
〇、六类赛道与核心代表
| 类型 | 核心诉求 | 典型产品 | 目标用户 |
|---|---|---|---|
| ① 企业研发知识管理 | 项目-文档-代码一体化治理 | ONES Wiki | 中大型技术组织 |
| ② 个人知识管理(PKM) | 本地优先、双向链接、长期沉淀 | Obsidian、Logseq、思源笔记 | 研究者、知识工作者 |
| ③ 团队协作文档 | Wiki 与日常办公流融合 | Notion、Confluence、语雀、SharePoint | 企业团队 |
| ④ AI 记忆层 | Agent 跨会话状态保持 | Zep、Mem0、Letta、LangMem | AI 应用开发者 |
| ⑤ 企业 RAG 框架 | 文档向量化检索与问答 | Dify、RAGFlow、QAnything、WeKnora | 技术团队 |
| ⑥ 代码知识图谱 | 代码库结构化理解与压缩 | Graphify、LightRAG | 开发者 |
前两类面向”人如何组织知识”,后四类解决”AI 如何记忆与检索知识”,底层范式截然不同。同类型产品之间才构成有效比较。
一、企业研发知识管理:ONES Wiki
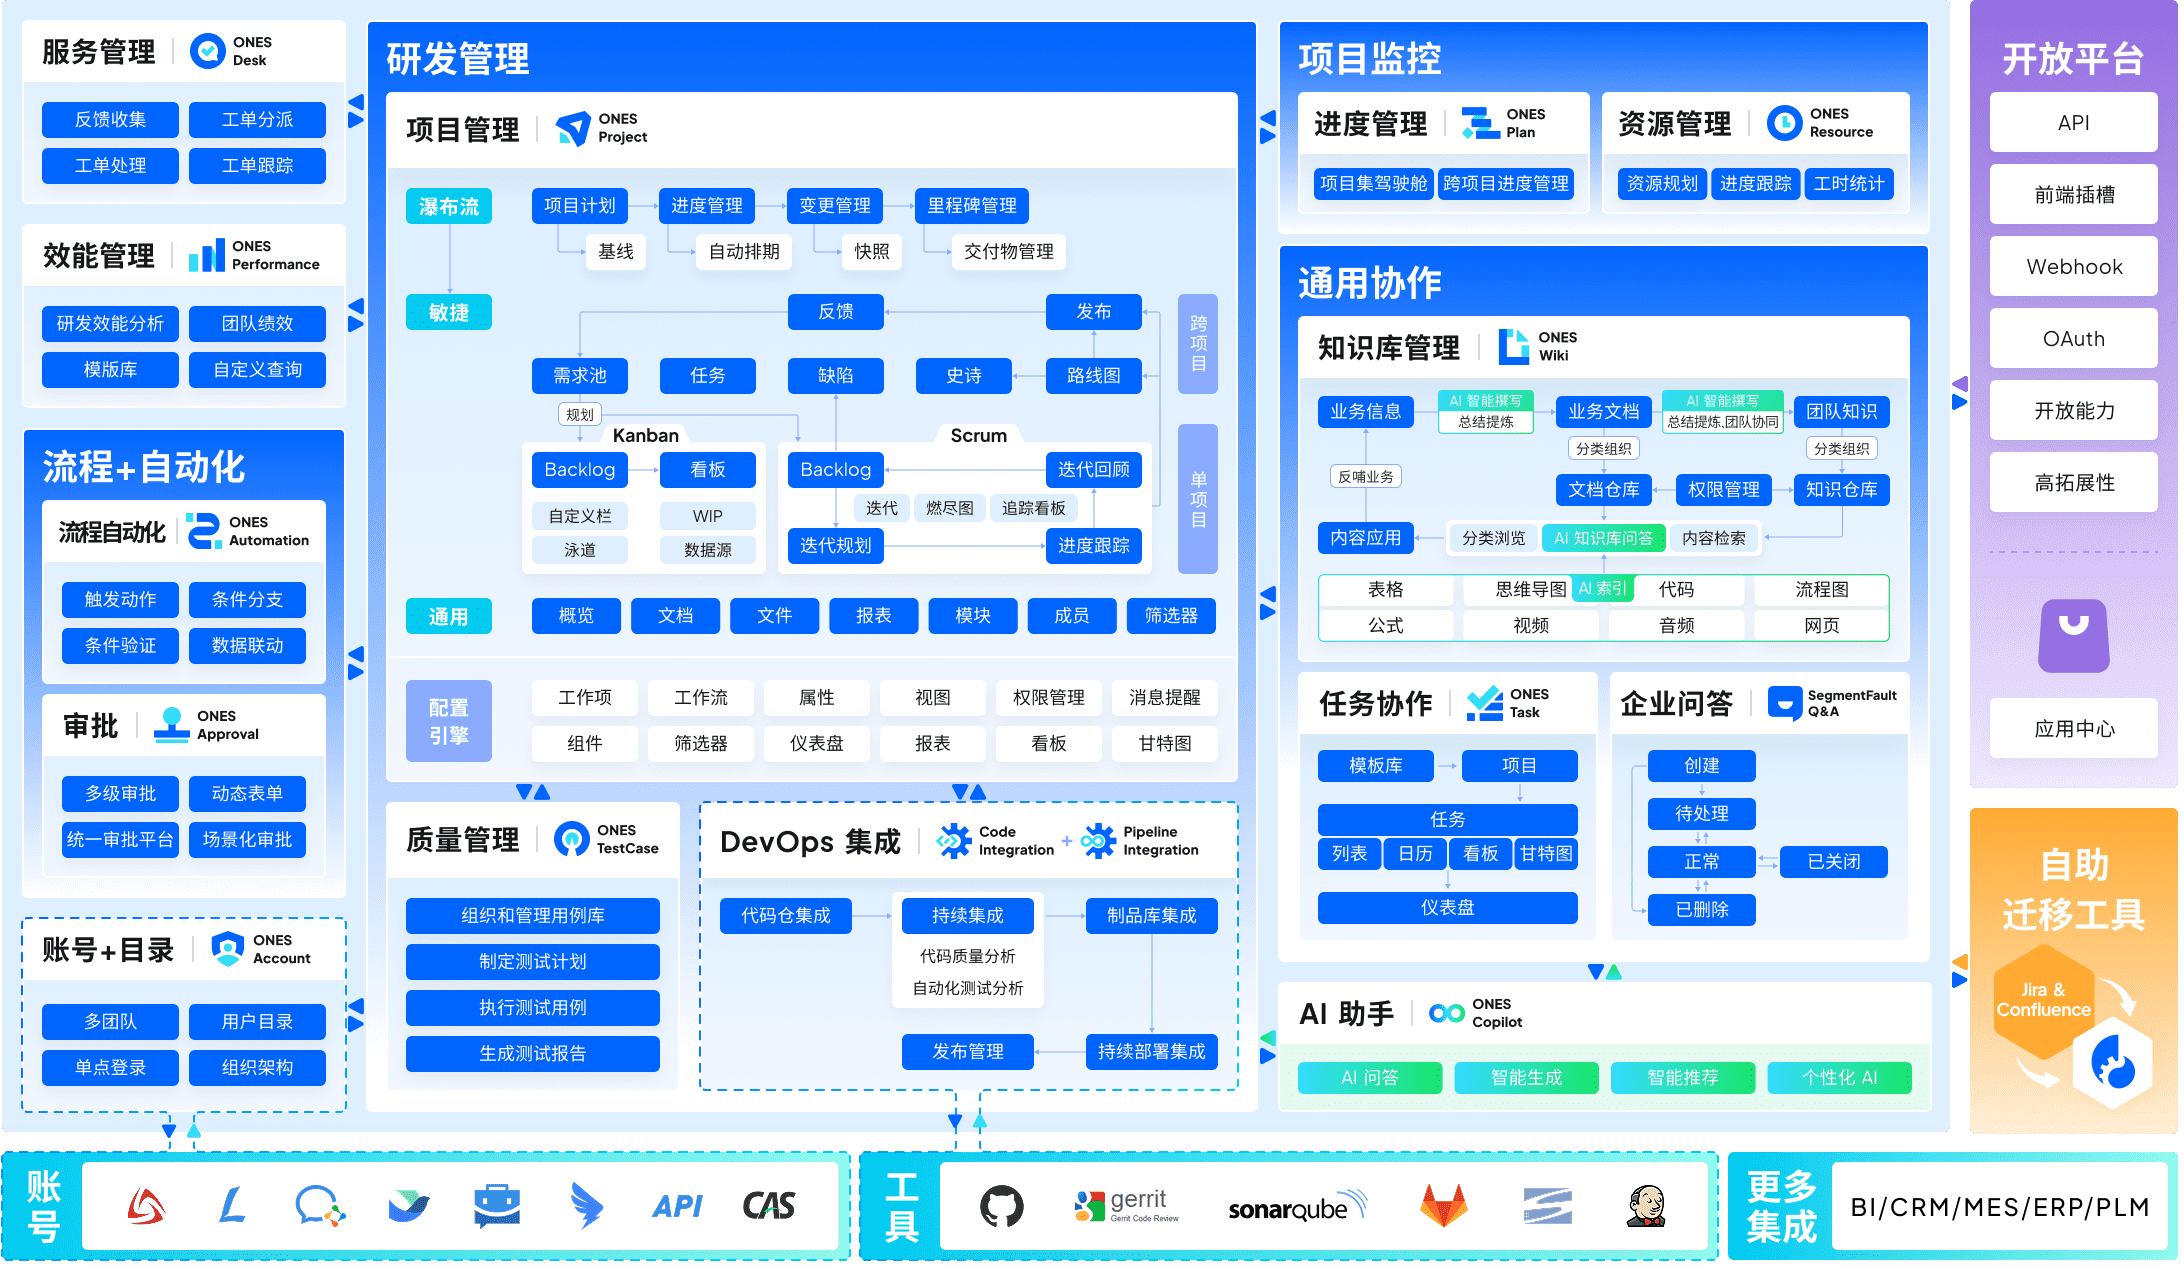
中大型技术组织面临的核心矛盾,是项目管理、需求文档、测试用例、代码仓库分散在不同系统,信息孤岛导致协作摩擦与版本混乱。ONES 作为企业级研发管理平台,其 Wiki 模块与项目管理、需求跟踪、测试管理、CI/CD 流水线深度贯通,形成从需求定义到代码交付的完整知识链路。
关键能力体现在三个层面:
- 流程治理:支持复杂权限模型与跨团队审批流,满足金融、电信等强合规行业的审计要求
- 数据驱动:内置研发效能度量体系,将文档沉淀与交付效率、缺陷密度等指标关联,支撑持续改进
- 私有化部署:完整支持本地或专属云环境,适配政企客户的网络隔离与数据主权需求
适用场景:百人以上研发团队、需将知识库嵌入研发主流程、对跨项目知识复用有明确诉求的组织。实施周期与组织规模正相关,建议分阶段推进权限体系与模板标准化。
二、个人 PKM 赛道
2.1 产品定位
| 产品 | 核心定位 | 开源协议 | 数据存储 |
|---|---|---|---|
| Obsidian | 本地 Markdown + 插件生态,自由度最高 | 核心闭源,个人免费 | 纯本地 |
| Logseq | 开源大纲式双链笔记,开发者友好 | AGPL-3.0 | 纯本地 |
| 思源笔记 | 块级编辑 + 中文优化,本地云可选 | AGPL-3.0 | 本地 + 可选云端 |
2.2 能力对比
| 维度 | Obsidian | Logseq | 思源笔记 |
|---|---|---|---|
| 双向链接 / 图谱 | 极强,可视化成熟 | 原生支持 | 块级引用 |
| 插件 / 扩展 | 生态最丰富 | 中等 | 中等 |
| PDF 标注 | 插件实现 | 原生 | 原生 |
| 协作能力 | 弱,依赖第三方 | 弱 | 支持 |
| 学习成本 | 中等,需配置 | 中等 | 较低 |
Obsidian 适合愿意投入时间搭建工作流的重度用户;Logseq 吸引偏好开源与大纲思维的开发者;思源笔记在中文语境与块编辑体验上更具亲和力。三者均非为 AI 检索设计,与 RAG 框架不存在替代关系。
三、团队协作文档赛道
该领域产品数量逾二十款,选型首要考量是与现有办公生态的绑定程度,强行迁移成本通常高于收益。
| 产品 | 生态归属 | 典型场景 | 私有化能力 |
|---|---|---|---|
| Notion | 独立 SaaS | 初创团队 All-in-One | 有限 |
| Confluence | Atlassian | 深度绑定 Jira 的研发团队 | Data Center 版 |
| 语雀 | 阿里 | 国内技术团队知识沉淀 | 支持 |
| SharePoint | Microsoft 365 | 大型政企门户与合规归档 | 强 |
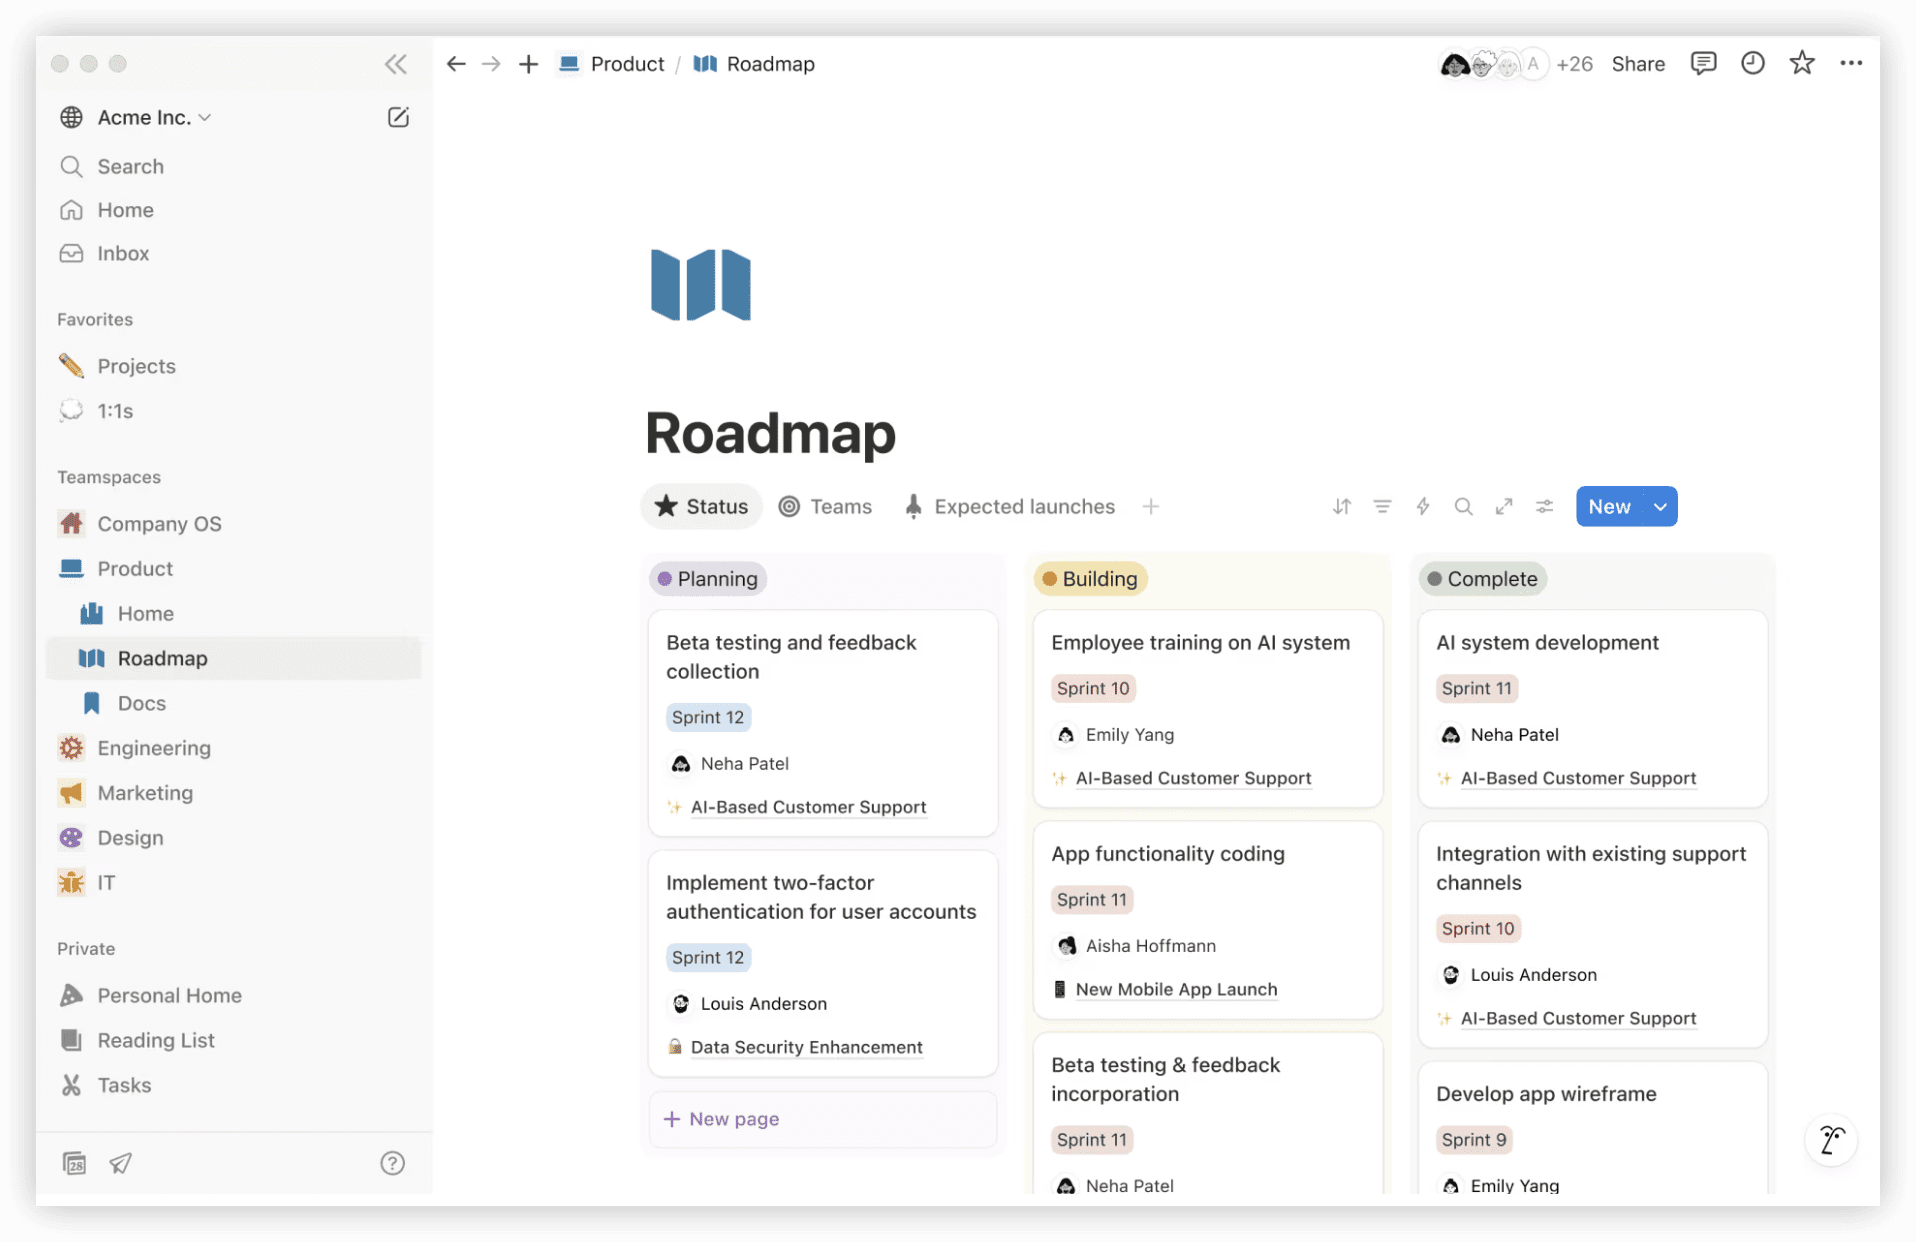
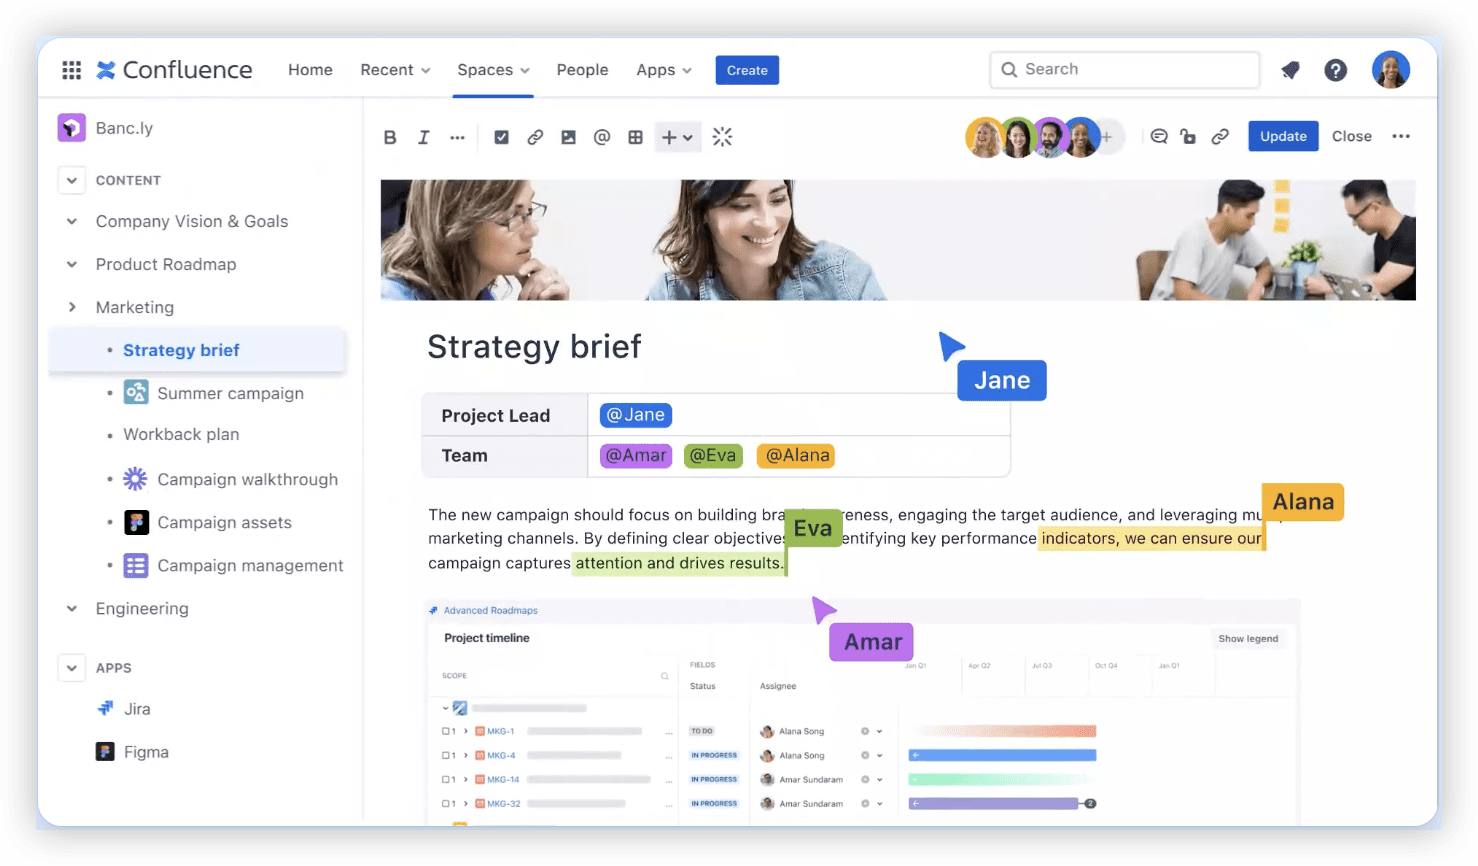
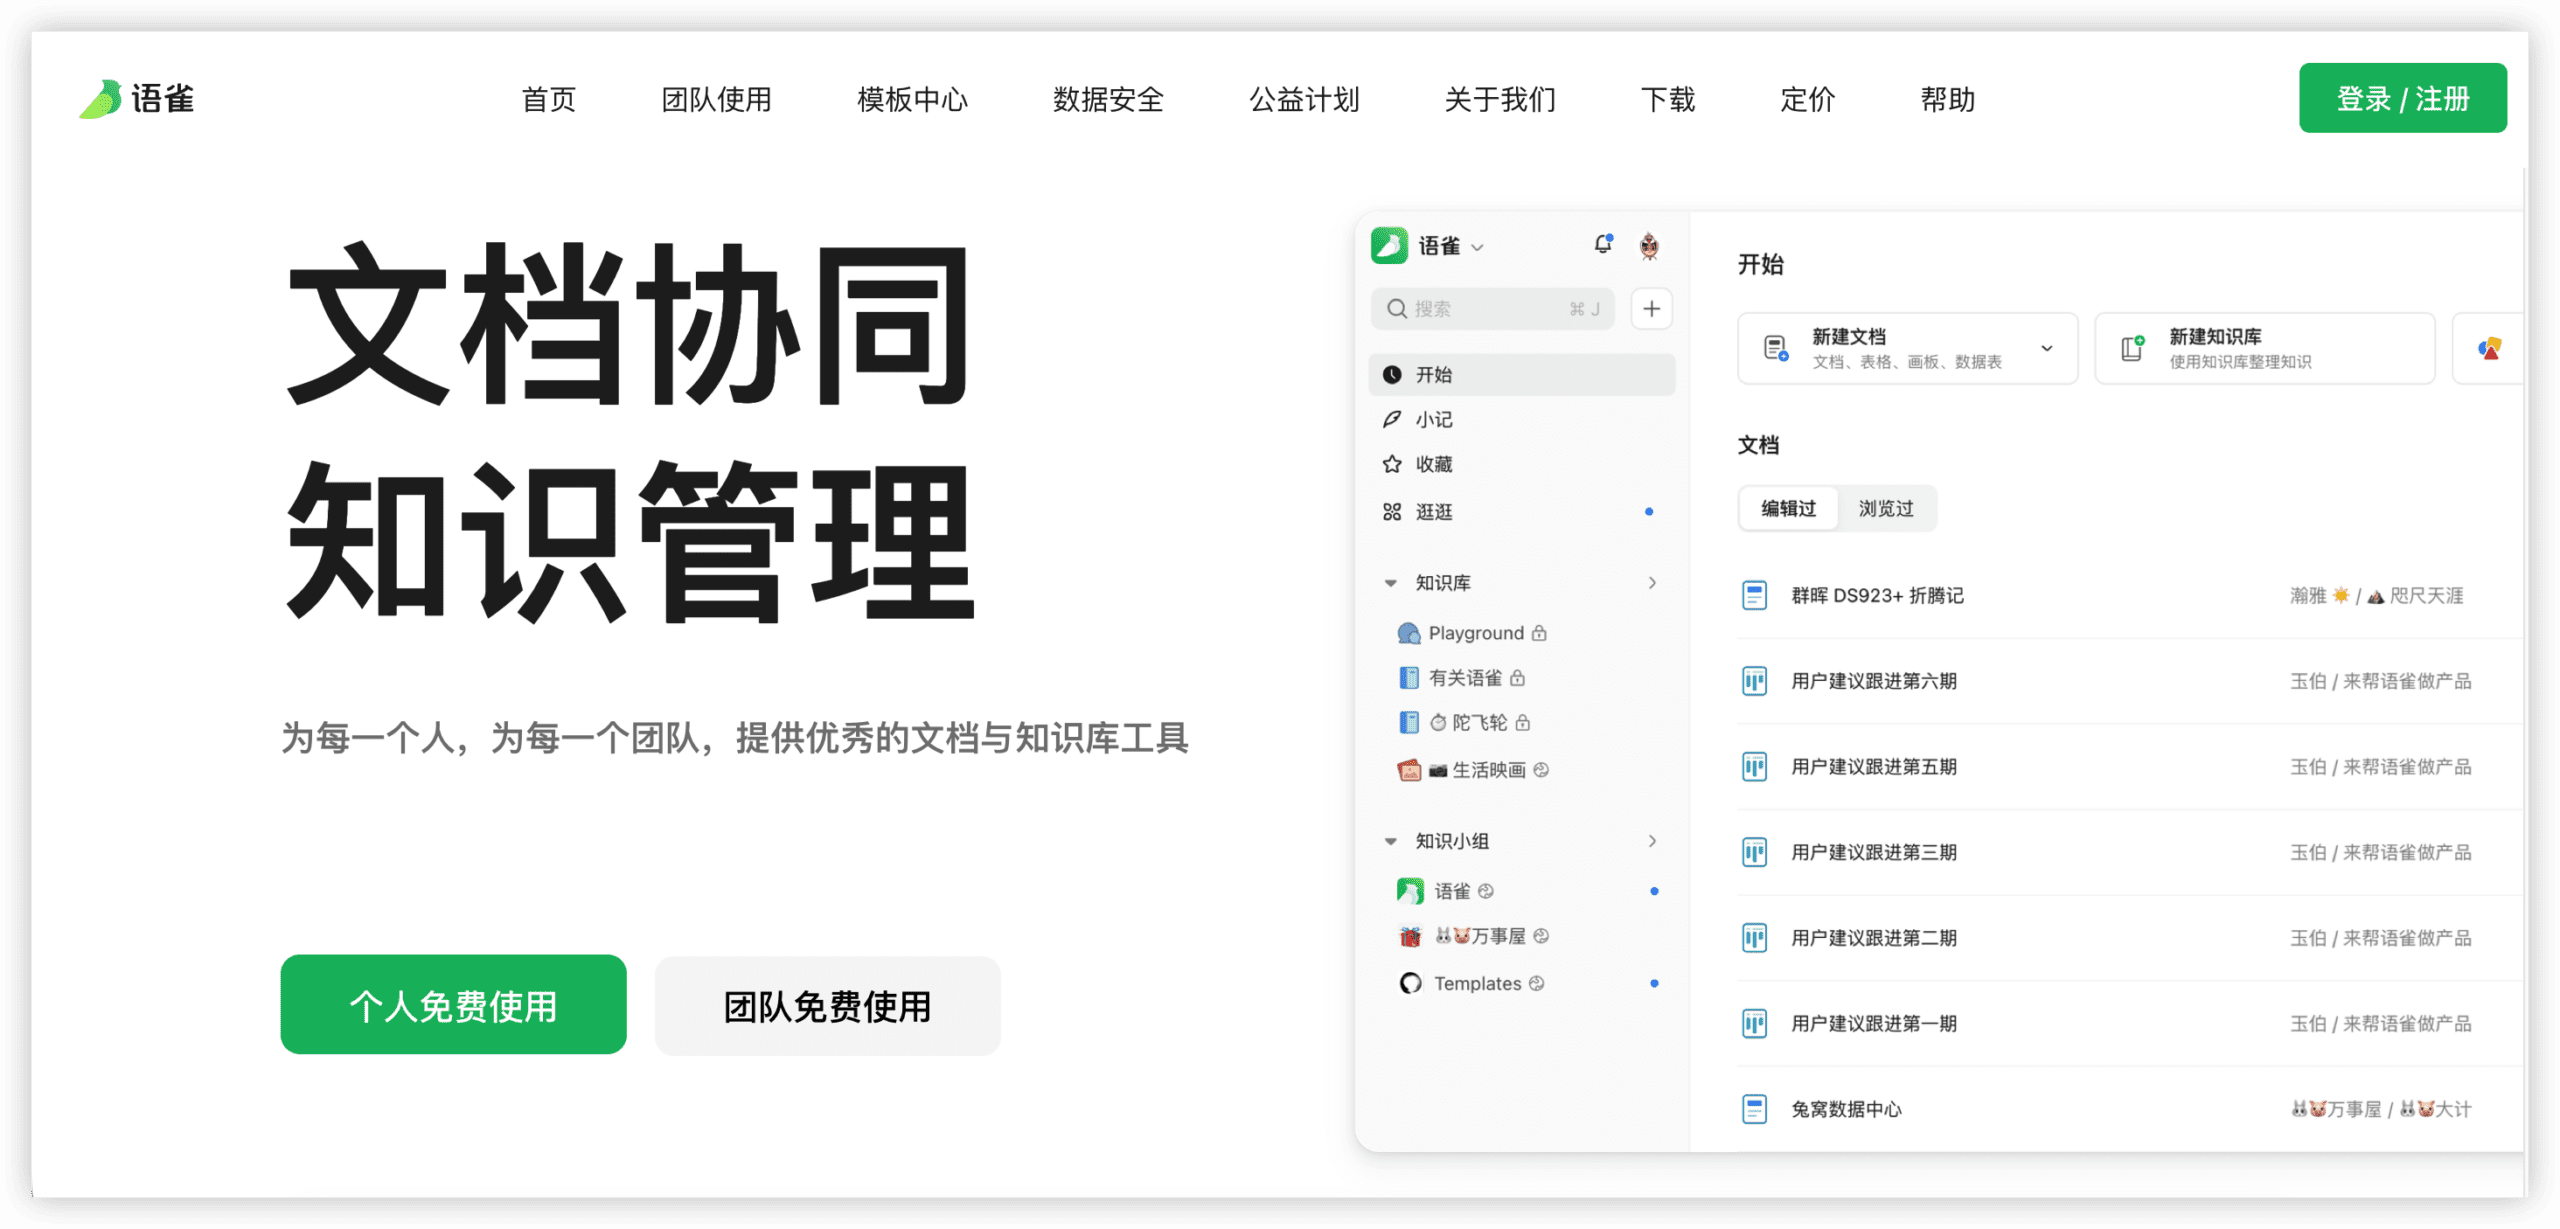
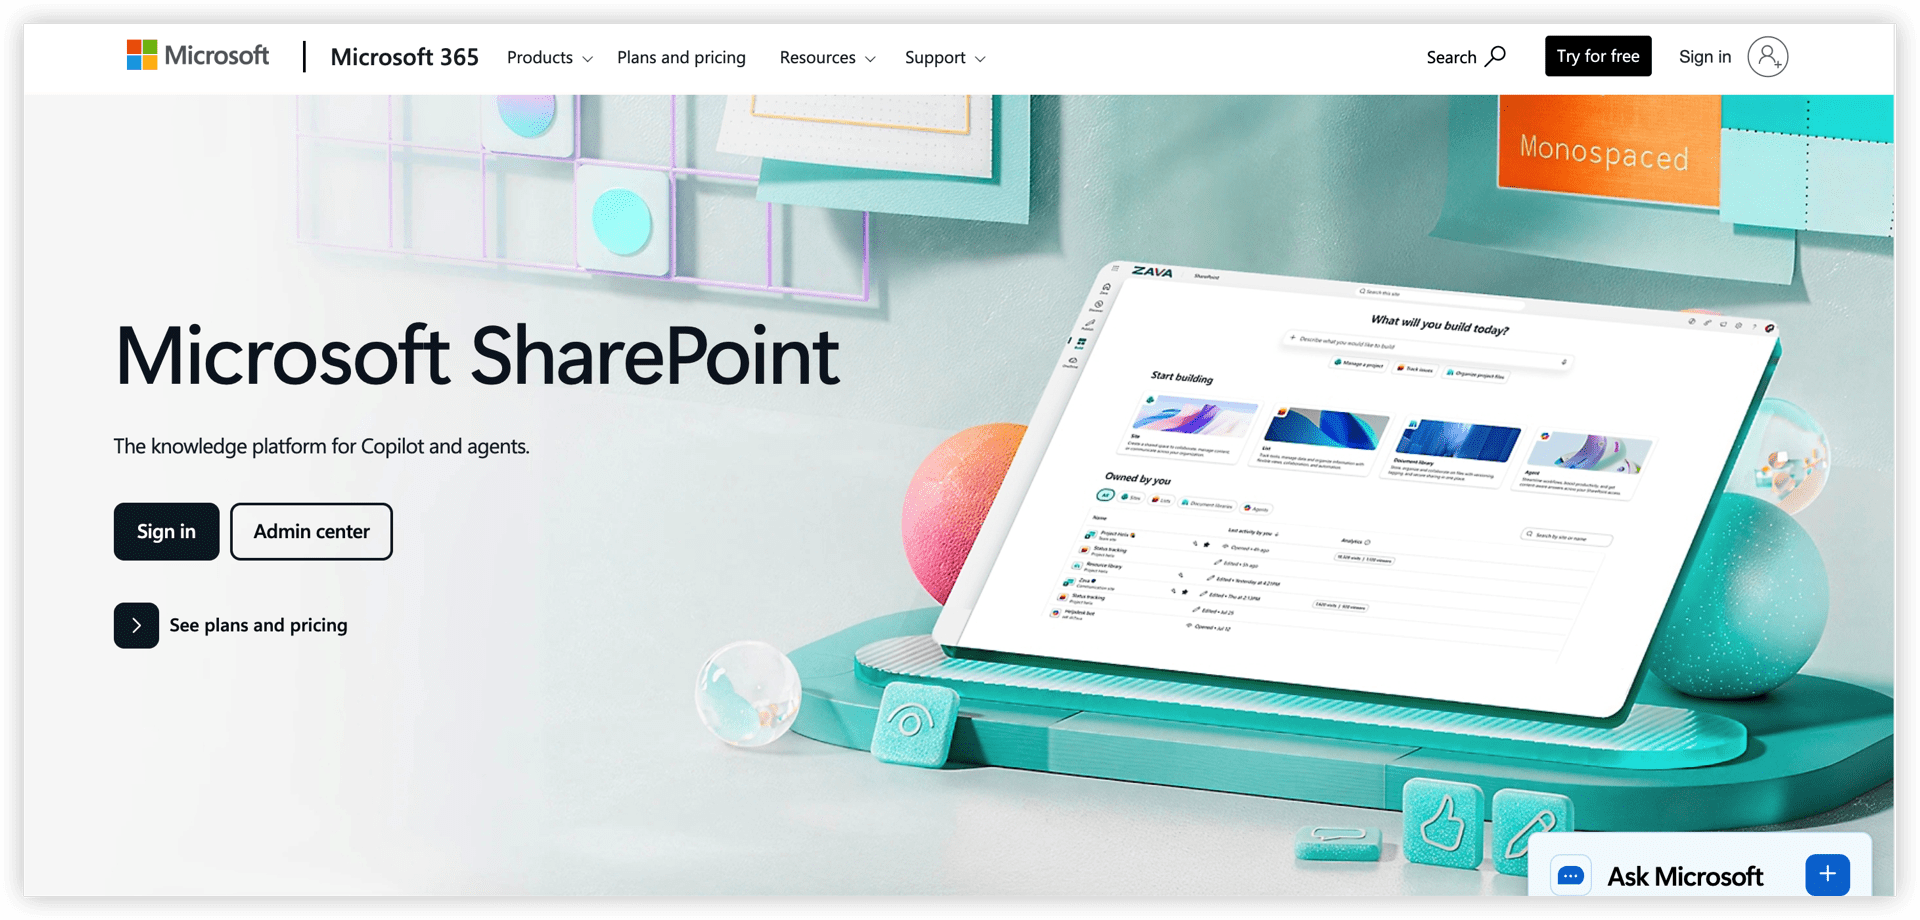
传统协作文档的 AI 能力多为附加模块(如 Notion AI、智能摘要),底层仍以人工结构化内容为主。若核心诉求是 AI 自主检索与推理,需转向 RAG 或记忆层方案。
四、AI 记忆层赛道
该赛道解决 Agent”跨会话遗忘”问题,四款产品代表不同技术路线。
4.1 核心参数
| 产品 | 技术特色 | 开源协议 | Stars(约 2026-09) |
|---|---|---|---|
| Zep | 时序图谱,事实带有效期 | 商业 + 开源层 | — |
| Mem0 | 三行接入,框架无关 | Apache-2.0 | 64K+ |
| Letta | Agent 自主管理记忆块 | Apache-2.0 | 23K+ |
| LangMem | 程序记忆,LangGraph 原生 | LangChain 生态 | — |
4.2 关键差异
Zep 的不可替代性在于时序推理与企业合规(SOC2/HIPAA)。用户偏好或事实状态随时间变化时,能正确处理”曾任职 A 公司,现就职 B 公司”类场景。
Mem0 以接入速度取胜,三行代码即可集成,支持语义、BM25、实体多路检索,托管与自托管双模式,p95 延迟约 0.2 秒。
Letta 赋予 Agent 最高自主权:自编辑记忆块、离线整理(Sleep-Time Compute)、可视化调试界面。代价是学习曲线陡峭,Token 开销显著增加。
LangMem 唯一支持 Agent 改写自身系统提示(程序记忆),但与 LangGraph 深度耦合,第三方基准显示 p95 延迟达 59.82 秒,亚秒级场景不适用。
选型红线:低延迟交互必选 Mem0 或 Zep;Agent 行为进化选 Letta 或 LangMem;医疗金融合规选 Zep。
五、企业 RAG 框架赛道
5.1 产品概览
| 产品 | 核心定位 | 协议 | Stars(约) |
|---|---|---|---|
| Dify | 可视化 LLMOps + 生态最广 | Apache-2.0 衍生 | 154K+ |
| RAGFlow | 文档解析深度最强 | Apache-2.0 | 高 |
| QAnything | 跨语言 + 全离线运行 | AGPL-3.0 | 中 |
| WeKnora | 三模式一体,快速上手 | MIT | — |
| Yuxi(语析) | 沙盒隔离 + 一体化平台 | MIT | — |
5.2 能力矩阵
| 维度 | Dify | RAGFlow | QAnything | WeKnora | Yuxi |
|---|---|---|---|---|---|
| 可视化编排 | 强 | 画布模式 | 弱 | 中等 | 强 |
| 文档解析 | 中等 | DeepDoc 最强 | 中文优化 | 中等 | 中等 |
| Agent 沙盒 | v0.25+ 支持 | v0.25+ 支持 | 无 | 无 | 独有文件系统隔离 |
| 私有化 | 支持 | 支持 | 全离线 | MIT 友好 | MIT 友好 |
| 上手难度 | 低-中 | 中等 | 中等 | 最低 | 高 |
5.3 差异化解读
Dify 凭借 154K Stars 与 Marketplace 插件市场形成最大开发者生态,SOC2 Type II 与 ISO 27001 企业版认证降低生产环境采纳门槛,适合从原型到量产的平滑过渡。
RAGFlow 的 DeepDoc 引擎采用 OCR + 表格结构识别 + 文档布局分析三视觉模型,对多栏排版、嵌套表格、图文混排的保留效果领先。0.25 版本新增 Agent 沙盒与用户级记忆隔离。
QAnything 支持纯 CPU 离线运行(默认需 20GB 以上内存),BCEmbedding 在双语跨语言场景表现突出。需注意 AGPL-3.0 协议的强 Copyleft 属性,闭源商用需法律评估。
WeKnora 与 Yuxi 均为国产 MIT 协议开源,前者以降低首次部署门槛见长,后者以 Agent 文件操作沙盒隔离为独特卖点,二者功能重叠度高,建议根据团队运维能力二选一。
六、代码知识图谱赛道
| 产品 | 核心能力 | 协议 | 关键指标 |
|---|---|---|---|
| Graphify | 代码库转可查询图谱 | MIT | 71.5× Token 压缩 |
| LightRAG | 向量 + 图谱双路检索 | MIT | 快速上手 |
Graphify 采用 tree-sitter 确定性解析构建 AST,零 LLM 调用即可完成代码图谱化,每条边标注置信度类型(提取 / 推断 / 歧义),可解释性优于纯向量相似度。已与 20 余款 AI 编程助手集成。局限在于专注代码场景,不适用于通用文档。
七、跨赛道选型决策树
7.1 首要问题:服务对象是”人”还是”AI”?
路径 A:人需要记忆与组织知识
- 个人深度研究 → Obsidian / Logseq / 思源笔记
- 企业研发一体化 → ONES Wiki
- 通用团队协作文档 → 按现有办公生态选择(Notion / Confluence / 语雀 / SharePoint)
路径 B:AI 需要记忆、检索或推理
- Agent 跨会话状态保持 → 进入记忆层细分
- 时序事实 + 合规 → Zep
- 快速接入 + 低延迟 → Mem0
- Agent 自主进化 → Letta
- LangChain 生态深度用户 → LangMem
- 文档向量化问答 → 进入 RAG 细分
- 最快验证 → WeKnora
- 可视化编排 + 生态扩展 → Dify
- 复杂 PDF / 表格解析 → RAGFlow
- Agent 文件操作安全隔离 → Yuxi
- 全离线 + 跨语言,接受 AGPL → QAnything
- 代码库结构化理解 → Graphify
7.2 典型组合方案
| 场景 | 推荐组合 |
|---|---|
| 中大型研发团队全链路管理 | ONES(项目管理 + Wiki + 效能度量) |
| 个人知识沉淀与写作 | Obsidian / Logseq |
| 企业 Wiki 叠加 AI 问答 | Confluence / 语雀 + Dify / RAGFlow |
| 有状态 AI 客服 | Mem0(通用)/ Zep(合规) |
| 合同 / 报告类复杂文档 RAG | RAGFlow |
| 代码库 AI 辅助开发 | Graphify + 主流 AI 编程助手 |
八、风险与验证建议
协议合规:AGPL-3.0 产品(QAnything、Logseq、思源笔记)闭源商用需法务审查;MIT / Apache-2.0(WeKnora、Yuxi、Mem0、Letta、Dify、RAGFlow、Graphify)商用限制较少。
赛道错配:将 RAG 框架用于个人笔记管理、或将记忆层用于文档批量问答,均会导致实施成本失控。先明确”人读”或”AI 读”的本质差异,再进入同类型产品比较。
动态验证:Stars 数、版本迭代、定价策略变化频繁,以各项目官方仓库 2026 年最新信息为准。对于赛道内头部产品(如 Mem0 vs Zep、WeKnora vs Yuxi),建议以同数据集运行 POC,实测检索准确率、端到端延迟与 Token 消耗。
九、结语
AI 知识库工具的选择,本质是”谁使用知识”与”如何使用知识”两个问题的交点。企业研发治理需一体化平台支撑流程与度量;个人知识工作者追求本地可控与长期沉淀;AI 应用开发者则在延迟、自主权、合规之间寻找平衡点。
没有 universally optimal 的工具,只有与组织规模、技术栈、合规要求、团队能力相匹配的方案。建议在正式采购或大规模实施前,以最小可行范围验证核心场景,用实测数据替代品牌偏好。
常见问题
Q1:ONES 与 Notion、Confluence 的核心差异是什么?
ONES 面向研发场景原生设计,项目管理、需求跟踪、测试用例、代码管理与 Wiki 共享同一数据模型;Notion 与 Confluence 属于通用协作文档,需通过集成或插件连接研发工具链,数据贯通深度不同。
Q2:个人用户是否需要关注 RAG 框架?
若仅需管理个人笔记与文献,PKM 工具更为合适。RAG 框架的部署复杂度与运维成本对个人场景属于过度工程,除非有自建 AI 问答助手的明确需求。
Q3:记忆层产品能否替代传统数据库?
不能。记忆层专为非结构化语义记忆设计,强调模糊匹配与时序推理;事务型数据存储、强一致性查询仍需关系型或文档数据库。
Q4:开源协议如何影响企业选型?
MIT 与 Apache-2.0 允许闭源修改与商用,需保留版权声明;AGPL-3.0 要求网络服务同样开源,SaaS 化部署时传染风险显著。建议法务部门提前介入评估。
Q5:如何评估 RAG 框架的文档解析质量?
准备三类测试样本:扫描版 PDF(检验 OCR)、复杂表格(检验结构保留)、多栏图文混排(检验阅读顺序)。对比召回片段与原始文档的对应完整性,而非仅看最终回答流畅度。