 400-188-1518
2026 年 AI 知识库工具全景解析:五条赛道与选型指南
构建 AI 知识库已成为企业数字化转型的关键议题。本文系统梳理 2026 年主流工具格局,涵盖 14 款代表性产品,按五条技术赛道逐一剖析:
- ONES — 企业级研发管理一体化平台
- Obsidian — 本地优先的个人知识管理系统
- Logseq — 开源大纲式双链笔记
- Roam Research — 图谱化深度写作工具
- 思源笔记 — 中文本地化块编辑器
- Zep — 时序感知 AI 记忆层
- Mem0 — 框架无关通用记忆服务
- Letta — Agent 自主记忆运行时
- LangMem — LangGraph 原生记忆 SDK
- WeKnora — 快速上手的开源 RAG 框架
- Yuxi(语析)— 全栈智能体平台
- Dify — 可视化 LLMOps 编排引擎
- RAGFlow — 深度文档解析专家
- QAnything — 全离线跨语言 RAG 方案
核心前提:AI 知识库领域已分化为本质不同的技术范式。跨赛道直接比较会造成失真,正确方法是先识别业务场景所属赛道,再在赛道内部进行硬指标对比。以下按赛道组织内容,文末提供跨赛道选型框架。
数据截至 2026 年 9 月,动态指标以各项目官方仓库为准。许可协议对商用决策有实质影响,已逐一标注。
Table of Contents
赛道总览:五条技术路线与核心差异
| 赛道 | 本质特征 | 代表产品 | 目标用户 |
|---|---|---|---|
| ① 企业研发管理 | 需求-代码-测试-文档全链路贯通 | ONES | 中大型技术组织 |
| ② 个人 PKM | 本地优先 + 双向链接,服务于人的认知 | Obsidian、Logseq、Roam Research、思源笔记 | 个人研究者 |
| ③ AI 记忆层 | 解决 Agent 跨会话状态丢失 | Zep、Mem0、Letta、LangMem | AI 开发者 |
| ④ 企业 RAG 框架 | 文档向量化检索与问答生成 | WeKnora、Yuxi、Dify、RAGFlow、QAnything | 技术团队 / 企业 |
| ⑤ 代码知识图谱 | 显式关系建模,可解释代码理解 | LightRAG、Cognee、Graphify | 开发者 |
赛道 ①② 关注「人如何组织知识」;赛道 ③④⑤ 关注「AI 如何存储与检索知识」。两种范式的设计目标、交互逻辑与评估标准截然不同,仅在各自赛道内部比较才有意义。
赛道一:企业研发管理
中大型技术组织面临的核心矛盾,是工具链割裂导致的信息孤岛与流程断点。需求文档、代码仓库、测试用例、发布流水线分散于不同系统,协作成本随规模指数级上升。
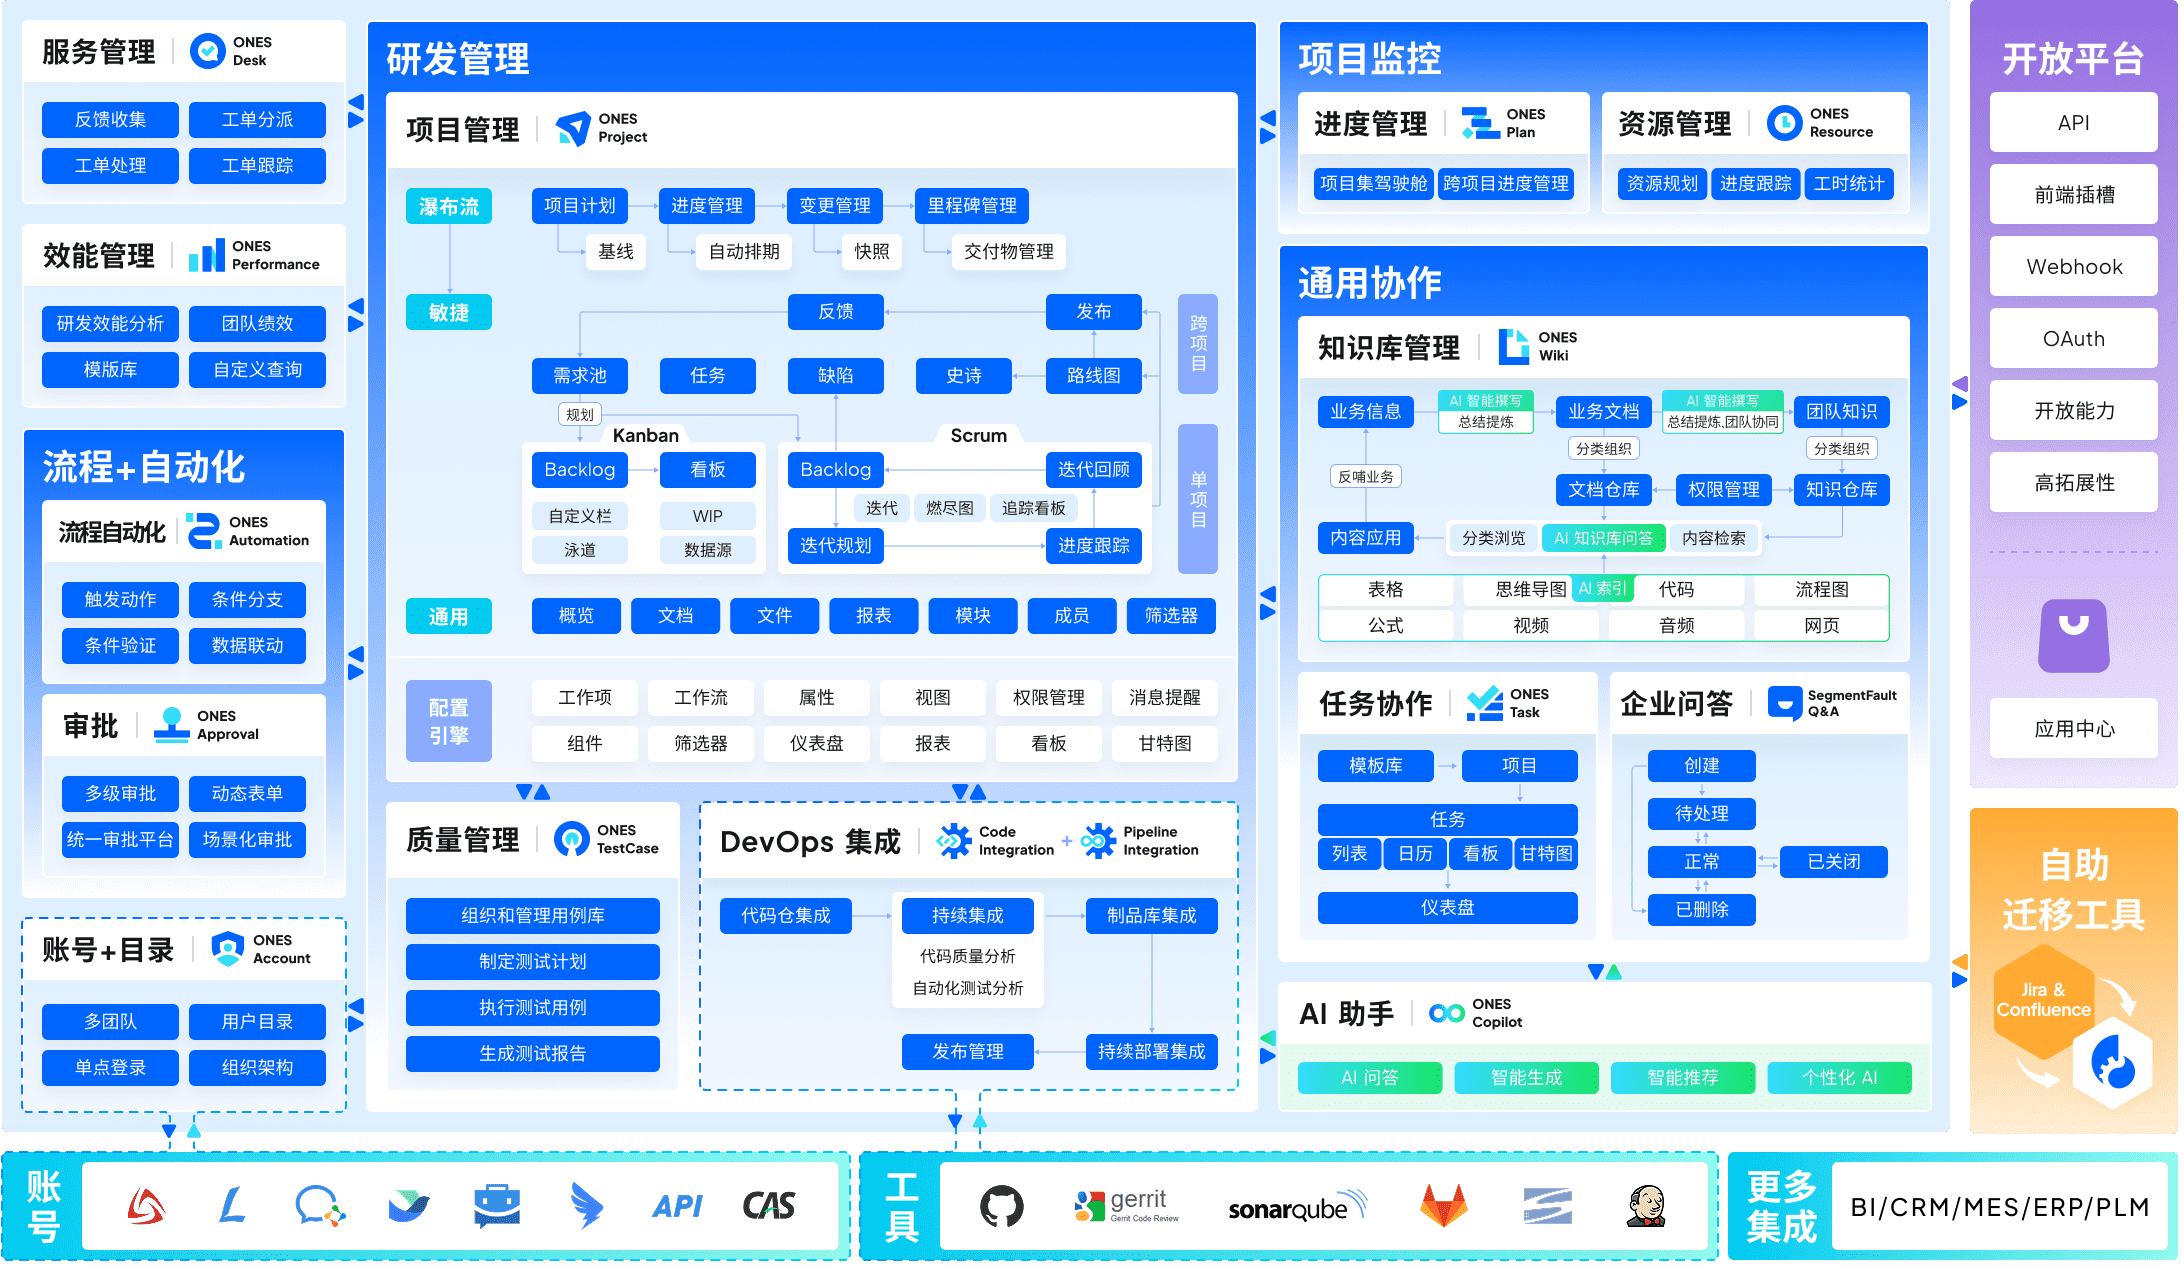
ONES 定位于解决这一系统性问题。其平台覆盖项目管理、需求追踪、知识库沉淀、测试管理、CI/CD 流水线与代码托管六大模块,通过统一数据模型实现研发全链路贯通。面向百人以上技术团队,ONES 支持复杂审批流配置、细粒度权限模型与跨部门协作治理,并内置研发效能度量体系,以数据驱动交付质量与效率的持续改进。对于已将研发管理视为核心竞争力的组织,一体化平台的价值在于减少上下文切换损耗,而非单一功能的极致优化。
赛道二:个人 PKM(Personal Knowledge Management)
产品定位速览
| 产品 | 一句话定位 | 开源协议 | GitHub Stars(约) |
|---|---|---|---|
| Obsidian | 本地 Markdown 存储 + 双向链接 + 插件市场,个人知识管理的事实标准 | 免费个人使用,核心闭源 | — |
| Logseq | 开源大纲式双链笔记,隐私敏感型用户与开发者的首选 | AGPL-3.0 | 高 |
| Roam Research | 每日笔记流 + 双向链接图谱的开创者,服务深度写作者与学者 | 商业 SaaS | — |
| 思源笔记 | 本地块级编辑 + 可选云端同步,Markdown 与块模型混合排版 | AGPL-3.0 | 中 |
能力矩阵对比
| 能力维度 | Obsidian | Logseq | Roam Research | 思源笔记 |
|---|---|---|---|---|
| 数据主权 | 纯本地 Markdown 文件 | 纯本地(Markdown/EDN 双格式) | 云端托管 | 本地为主,可选私有云服务 |
| 关联网络 | 极强,图谱可视化成熟 | 支持,大纲结构天然适合链接 | 理念开创者,图谱交互深度最佳 | 块级引用,中文场景优化 |
| 内容粒度 | 文件级,插件扩展至块级 | 大纲节点级 | 块级原子化 | 原生块模型 |
| PDF 批注 | 社区插件实现 | 内置支持 | 能力较弱 | 内置支持 |
| 扩展生态 | 最为繁荣,社区贡献活跃 | 中等规模 | 相对有限 | 中等规模,中文插件丰富 |
| 协同编辑 | 依赖第三方同步方案 | 依赖第三方同步方案 | 原生支持 | 原生支持 |
| 学习曲线 | 中等,需自行配置工作流 | 中等,大纲思维需适应 | 陡峭,方法论门槛高 | 较低,中文界面降低认知负荷 |
各产品适用边界
Obsidian 的优势在于生态广度与自由度上限。数千款社区插件覆盖从 Zotero 文献管理到 Spaced Repetition 记忆曲线的各类需求。代价是核心代码闭源,协作能力薄弱,用户需投入时间搭建个性化工具链。适合愿意折腾、重视数据本地化的重度知识工作者。
Logseq 以真正开源(AGPL-3.0)和隐私优先为差异化支点。大纲式编辑对结构化思维友好,开发者可深度定制。UI 精致度与插件丰富度略逊于 Obsidian,但协议透明度使其成为对软件自由有执念的用户的最优解。
Roam Research 的理念领先性体现在「每日笔记」流式工作法与图谱化知识涌现的设计哲学。年费订阅制、闭源架构与一般的协作体验构成主要阻力。适合学术研究、长篇写作等需要深度思考网络构建的场景。
思源笔记 在中文语境下具备显著体验优势:块编辑流畅、本地性能出色、云服务可选且数据格式开放。社区规模相对较小,但核心功能完整度已能满足多数个人用户的知识沉淀需求。
赛道结论:重视隐私与生态选 Obsidian 或 Logseq;追求思维网络深度选 Roam;中文用户优先体验选思源。此赛道产品与 AI 记忆层存在本质分野——PKM 服务于人的阅读理解,记忆层服务于机器的信息提取。
赛道三:AI 记忆层——Agent 的状态持久化
大语言模型的无状态特性导致 Agent 在跨会话场景中「失忆」。记忆层技术通过外部存储与检索机制,赋予 Agent 持续认知能力。该赛道 2026 年形成四足鼎立格局。
产品定位
| 产品 | 核心定位 | 开源协议 | Stars(约,2026-09) |
|---|---|---|---|
| Zep | 时序上下文图谱,处理事实的时间演化 | 商业服务 + 部分开源 | — |
| Mem0 | 通用记忆层,接入成本最低,框架零绑定 | Apache-2.0 | 64K+ |
| Letta(原 MemGPT) | Agent 自主管理记忆分区,类操作系统抽象 | Apache-2.0 | 23K+ |
| LangMem | LangChain/LangGraph 生态原生记忆 SDK | 开源(LangChain 子项目) | — |
技术能力硬对比
| 能力维度 | Zep | Mem0 | Letta | LangMem |
|---|---|---|---|---|
| 记忆分层 | 时序图谱结构 | 用户/会话/Agent 三级隔离 | 核心/回忆/归档三级置换 | 语义/情景/程序三类记忆 |
| 时序推理 | 最强,支持事实有效期与版本演化 | 部分支持 | 不支持 | 不支持 |
| Agent 自操作记忆 | 有限接口 | 提取与更新 | Agent 自主编辑记忆块 | 支持,含程序记忆改写 |
| 冲突消解 | 图谱合并算法 | 自动去重 | 自编辑覆盖 | 后台 Manager 调度 |
| 合规认证 | SOC2/HIPAA 完备 | SOC2/HIPAA/BYOK | — | 依赖部署环境 |
| 框架耦合 | 中等 | 完全解耦 | 深度绑定其运行时 | 强绑 LangGraph |
| 部署模式 | 托管服务 + 部分自托管 | 托管 + 自托管双模式 | 自托管(Docker) | 托管服务 |
不可替代的差异化价值
Zep 的双王牌是时序推理与企业合规。用户属性从 Adidas 迁移至 Nike 时,系统能正确处理品牌偏好的时间演化;SOC2/HIPAA 认证使其成为医疗、金融等监管敏感行业的默认选项。
Mem0 的核心竞争力是接入效率。三行代码即可完成集成,框架无关设计支持任意 Agent 架构,多信号检索(语义向量 + BM25 + 实体提取)保障召回质量。托管与自托管双模式覆盖从原型到生产的全生命周期。
Letta 将自主权让渡给 Agent 本身:自编辑记忆块、Sleep-Time Compute 离线整理、ADE 可视化调试。代价是学习曲线陡峭、自编辑行为可能破坏 prompt 缓存、Token 消耗显著高于竞品。
LangMem 的独特能力是程序记忆——Agent 可改写自身系统提示,实现行为层面的自我进化。与 LangGraph 的深度集成既是优势也是枷锁:已在该生态内的团队获得无缝体验,异构系统则面临迁移成本。需注意第三方基准测试显示其 p95 延迟达 59.82 秒,亚秒级响应场景应转向 Mem0(0.2 秒级)或 Zep。
选型红线:交互式 Agent 要求低延迟 → 排除 LangMem,在 Mem0 与 Zep 间选择;需要 Agent 自主进化行为 → Letta 或 LangMem;强监管行业涉及时序事实 → Zep 为唯一解。
赛道四:企业 RAG 框架——文档到问答的工程化
RAG(Retrieval-Augmented Generation)框架解决的是「如何让 AI 准确理解企业私有文档并回答业务问题」。该赛道 2026 年呈现工具爆发,以下五款产品覆盖不同工程偏好。
产品定位
| 产品 | 核心定位 | 开源协议 | Stars(约) |
|---|---|---|---|
| WeKnora | 腾讯开源,三模式一体,工程启动成本最低 | MIT | — |
| Yuxi(语析) | 全栈智能体平台,知识库/图谱/Agent/沙箱一体化程度最高 | MIT | — |
| Dify | 可视化 LLMOps + Agent 编排,社区与插件生态最广 | Apache-2.0 衍生 | 154K+ |
| RAGFlow | 专注文档问答,复杂版式解析能力最强 | Apache-2.0 | 高 |
| QAnything | 网易有道出品,跨语言检索 + 全离线运行 | AGPL-3.0 | 中 |
功能矩阵
| 能力维度 | WeKnora | Yuxi | Dify | RAGFlow | QAnything |
|---|---|---|---|---|---|
| 知识库 RAG | ✓ | ✓ | ✓ | ✓ | ✓ |
| 知识图谱 | ✓ | ✓ | 插件扩展 | — | — |
| 元数据过滤 | 图检索支持 | ✓ | ✓ | ✓ | 基础支持 |
| 可视化工作流 | 中等 | ✓ | 强 | 画布式编排 | 弱 |
| Agent 编排 | 中等 | 沙箱隔离 | 强 | v0.20+ 支持 | 不支持 |
| 文档解析 | 中等 | 中等 | 中等 | DeepDoc 最强 | 中文优化强 |
| 混合检索 + Rerank | ✓ | ✓ | ✓ | 三路并行 | 两阶段 |
| 代码执行沙箱 | — | 独有 | 插件 | v0.25 Agent 沙箱 | — |
| 私有化部署 | MIT 商用友好 | MIT 商用友好 | ✓ | ✓ | 全离线 |
| 工程启动难度 | 最低 | 高 | 低-中 | 中等 | 中等 |
关键差异化
WeKnora 的价值在于降低首次工程验证的门槛。MIT 协议消除商用顾虑,三模式一体设计(检索/对话/Agent)让团队快速验证「文档变问答」的可行性,适合 PoC 阶段追求速度的场景。
Yuxi 的独占性能力是沙箱隔离文件系统——Agent 的文件操作被限制在安全边界内,artifacts 产物可控交付。一体化程度最高,但运维复杂度同步最高,需要专门的技术团队支撑。
Dify 的 154K Stars 与 Marketplace 插件市场构成生态壁垒。可视化编排降低非开发者的参与门槛,知识流水线与可观测性设计支持从原型到生产的平滑过渡,企业版通过 SOC2 Type II 与 ISO 27001 认证。
RAGFlow 将资源集中于文档解析这一单点。DeepDoc 采用 OCR + TSR + DLR 三视觉模型,对表格、多栏排版、图文混排的版式还原能力领先。0.23+ 引入父子分块与图表上下文窗口,0.25 新增 Agent 沙箱与用户级记忆隔离。
QAnything 的差异化是极端环境适应性:拔网线运行、纯 CPU 推理、默认 ≥20GB RAM 即可工作。BCEmbedding 在双语跨语言场景达到 SOTA 水平。AGPL-3.0 强 Copyleft 协议构成商用限制,闭源产品需法务评估。
赛道内关系:WeKnora 与 Yuxi 因同为国产 MIT 开源、功能重叠度高,形成直接替代关系;Dify 与 RAGFlow 分别代表「编排广度」与「解析深度」的取舍;QAnything 因协议特性更适合内部系统或开源衍生场景。
赛道五:代码知识图谱
通用 RAG 对代码库的理解停留在文本相似度层面,难以捕捉函数调用、类继承、模块依赖等结构化关系。代码知识图谱通过 AST(抽象语法树)显式建模这些关系,实现可解释的代码智能。
| 产品 | 定位 | 关键特征 | 协议 |
|---|---|---|---|
| LightRAG | 图谱 RAG 框架 | 向量检索与图谱遍历双路召回,工程接入快 | MIT |
| Cognee | 知识图谱构建引擎 | 语义理解 + 关系图谱 + 时序维度,图谱能力纵深强 | 开源 |
| Graphify | 代码知识图谱生成器 | 单命令将代码库转为可查询图谱,71.5 倍 Token 压缩,零向量库依赖 | MIT |
Graphify 是 2026 年该细分领域的突破性产品(112K+ Stars)。其设计哲学强调确定性:基于 tree-sitter 的 AST 解析无需 LLM 参与即可建图,每条边标注 EXTRACTED(直接提取)/ INFERRED(推理生成)/ AMBIGUOUS(存疑)三级置信度,可解释性远超黑盒向量相似度。已与 20 余款 AI 编程助手(Claude Code、Cursor、Codex、Copilot 等)集成。局限在于场景聚焦——专为代码库设计,不适用于通用文档 RAG。
跨赛道综合速查
以下对比仅用于用户类型快速分流,不暗示产品优劣排序。
| 产品 | 所属赛道 | 核心卖点 | 工程复杂度 | 协议/商用 |
|---|---|---|---|---|
| ONES | ① 研发管理 | 全链路一体化,效能度量驱动 | 中(组织适配) | 商业授权 |
| Obsidian | ② PKM | 插件生态最繁荣 | 中 | 免费个人 |
| Logseq | ② PKM | 开源 + 本地大纲 | 中 | AGPL-3.0 |
| Notion | ② 协作 | All-in-One 工作空间 | 低 | SaaS |
| Zep | ③ 记忆层 | 时序推理 + 企业合规 | 中(需集成) | 商业服务 |
| Mem0 | ③ 记忆层 | 接入最快、框架无关 | 低 | Apache-2.0 |
| Letta | ③ 记忆层 | Agent 自主记忆管理 | 高 | Apache-2.0 |
| LangMem | ③ 记忆层 | 程序记忆 + LangGraph 原生 | 中高 | 开源 |
| WeKnora | ④ RAG | 工程启动最快 | 低 | MIT |
| Yuxi | ④ RAG | 沙箱隔离 + 一体化 | 高 | MIT |
| Dify | ④ RAG | 生态最广、编排最强 | 低-中 | Apache-2.0 |
| RAGFlow | ④ RAG | 复杂文档解析最强 | 中 | Apache-2.0 |
| QAnything | ④ RAG | 跨语言 + 全离线 | 中 | AGPL-3.0 |
| Graphify | ⑤ 代码图谱 | Token 压缩 71 倍 | 低 | MIT |
复杂度梯度:Mem0 ≈ WeKnora ≈ Obsidian(最易上手) < Zep / Dify / RAGFlow(需开发集成) < Letta / Yuxi / LangMem(需专职运维团队)
选型决策框架
第一步:确定赛道归属
问题 A:知识服务的对象是「人」还是「AI」?
- 人 → 赛道 ②(Obsidian / Logseq / Roam / 思源)或赛道 ①(ONES 等研发管理平台)
- AI → 进入问题 B
问题 B:AI 是否需要「跨会话记住用户偏好与历史事实」(有状态 Agent)?
- 是 → 赛道 ③
- 时序推理 + 行业合规(医疗/金融)→ Zep
- 最快接入、框架无关 → Mem0
- Agent 自主进化 + 可视化调试 → Letta
- 已在 LangChain/LangGraph 生态 → LangMem
- 否(将「文档」转化为「问答/检索/推理」)→ 赛道 ④⑤
- 快速验证、降低启动成本 → WeKnora
- 可视化编排 + 插件生态 → Dify
- 复杂版式(PDF/表格/多栏)解析 → RAGFlow
- Agent 需安全操作文件系统 → Yuxi
- 跨语言 + 全离线 + 注意协议限制 → QAnything
- 代码库理解 + 极致 Token 效率 → Graphify
高频场景组合
| 业务场景 | 推荐组合 |
|---|---|
| 中大型研发团队全链路管理 | ONES |
| 个人知识沉淀 + 本地数据主权 | Obsidian / Logseq |
| 企业团队 Wiki + AI 问答增强 | Confluence / 语雀 + Dify / RAGFlow |
| 有状态 AI 客服 / 个人助手 | Mem0(通用)/ Zep(合规时序) |
| 文档问答 PoC,速度优先 | WeKnora 或 Dify |
| 复杂 PDF/合同/报告 RAG | RAGFlow |
| Agent 动手执行任务 + 产出交付物 | Yuxi |
| 代码库 AI 辅助 + 成本控制 | Graphify |
| 国产大模型 + 私有化 + MIT 协议 | WeKnora / Yuxi(二选一) |
关键风险提示
许可协议风险:QAnything、Logseq、思源笔记采用 AGPL-3.0 强 Copyleft 协议,闭源商用需经法务合规评估;WeKnora、Yuxi、Graphify(MIT)、Mem0、Letta、Dify、RAGFlow(Apache-2.0)对商业应用更为友好。
赛道错配风险:将 RAG 框架用于个人知识管理、或将记忆层用于文档问答,均会导致工程投入与产出严重失衡。务必先明确业务场景所属范式,再进入具体产品比较。
指标时效性:Stars 数量、版本特性、定价策略变化迅速,决策前请以各项目官方仓库与文档为准(本文数据基准:2026 年 9 月)。
验证建议:WeKnora 与 Yuxi、Mem0 与 Zep 与 Letta 等赛道内「二选一」困境,最优解法是使用同一份业务数据集运行 PoC,实测 RAG 准确率、端到端延迟、Token 消耗三项核心指标。
结论
2026 年 AI 知识库工具的选择,本质是业务场景与技术范式的匹配问题。
企业研发管理场景,ONES 以全链路一体化与效能度量能力,支撑中大型技术组织的复杂协作治理。个人知识管理领域,Obsidian 生态最为成熟,Logseq 开源替代价值突出。AI 记忆层赛道,Mem0 以接入效率取胜,Zep 以时序合规见长,Letta 赋予 Agent 最大自主权,LangMem 深度服务 LangGraph 生态。企业 RAG 框架中,WeKnora 与 Yuxi 代表国产 MIT 开源路线,Dify 生态广度领先,RAGFlow 解析深度最强,QAnything 适应极端离线环境但需注意协议约束。代码知识图谱细分,Graphify 以确定性 AST 建图与惊人 Token 压缩比建立技术壁垒。
一句话总结选型逻辑:人的认知 → PKM 工具;AI 的状态 → 记忆层;AI 读文档 → RAG 框架;AI 懂代码 → 知识图谱。
本文提供赛道级全景视角,具体落地仍建议以小范围 PoC 验证假设,避免大规模投入后的范式错配。
常见问题
Q1:ONES 与通用协作工具(如 Notion、Confluence)的核心区别是什么?
通用协作工具以文档编辑与信息共享为核心,ONES 则以研发流程为轴线,将需求、代码、测试、发布串联为可度量、可优化的完整链路。前者解决「信息在哪」,后者解决「信息如何驱动交付改进」。
Q2:AGPL-3.0 协议对实际使用有何具体影响?
AGPL-3.0 要求网络服务的使用者也获得源代码,闭源产品若修改后提供在线服务,需公开衍生代码。内部使用不受影响,但 SaaS 化商用需法律评估。
Q3:记忆层产品能否替代传统数据库?
不能。记忆层优化的是语义检索与上下文召回,不具备事务一致性、复杂查询与结构化分析能力。典型架构是记忆层 + 关系数据库/图数据库协同工作。
Q4:RAG 框架的「幻觉」问题如何解决?
幻觉缓解需多层面措施:高质量文档解析(RAGFlow 优势)、精准检索(混合检索 + Rerank)、引用溯源(让模型标注答案来源)、人工反馈闭环。无单一工具能完全消除。
Q5:小型团队如何降低选型试错成本?
优先选择 MIT/Apache-2.0 协议产品,利用 Docker 快速本地部署;用 50-100 份真实业务文档构建测试集,统一评估准确率、延迟、运维复杂度三项指标;避免在 PoC 阶段过度追求功能全覆盖。