 400-188-1518
2026年测试管理软件选型指南:AI辅助测试的主流平台对比与落地建议
2026年,测试管理软件市场已形成清晰的格局。本文将系统梳理6款主流平台——ONES、Xray、TestRail、PractiTest、Testomat.io、Qase——从AI能力覆盖、基础管理效能到组织适配性三个层面展开分析,帮助团队找到与自身规模、流程成熟度相匹配的选型方案。
Table of Contents
一、从手工测试到AI辅助:五个核心环节的演进
AI对测试管理的渗透并非均匀分布,而是集中在五个关键节点。理解这些节点的变化,是评估软件价值的前提。
| 环节 | 手工模式 | AI辅助模式 |
|---|---|---|
| 用例设计 | 基于需求文档人工编写,依赖个人经验 | 解析需求自动生成分层用例草稿,人工审核后定稿 |
| 脚本转化 | 手动编码或复制粘贴至自动化框架 | 自然语言用例自动转换为可执行脚本,支持主流框架导出 |
| 缺陷治理 | 手工录入、状态流转、关联关系维护 | 通过接口协议实现查询、创建、更新的自然语言交互 |
| 覆盖追踪 | Excel矩阵维护,需求变更后手工调整 | 智能识别覆盖缺口,需求变更时自动标注重测范围 |
| 结果分析 | 人工统计通过率、逐条排查失败原因 | 识别 flaky test,基于风险与影响面智能排序测试优先级 |
二、选型评估的五个技术维度
上述五个环节对应到软件评估中,需要逐一考察其技术实现深度与业务可用性。
1. 智能用例生成
核心机制在于对非结构化需求文档的语义解析能力。优质工具不仅能提取功能点,还能识别边界条件、异常路径与数据约束,输出包含前置条件、操作步骤、预期结果的完整用例结构。需重点关注生成结果与业务语境的匹配度,以及需求变更后的增量更新效率。
2. 自动化脚本转换
考察点包括:支持的自动化框架范围(Selenium、Playwright、Cypress等)、生成代码的可维护性、以及是否支持在平台内直接触发执行。部分工具仅提供一次性导出,缺乏版本同步机制,长期维护成本较高。
3. 缺陷生命周期智能化
通过CLI工具或标准化协议接入,实现缺陷数据的自然语言操作。评估时需确认权限边界是否清晰、操作留痕是否完整,避免开放度过大导致的数据治理风险。
4. 覆盖率动态追踪
区别于静态矩阵,AI辅助的覆盖率追踪需要具备需求变更感知能力——当需求发生增删改时,自动计算受影响用例集,提示回归测试范围。部分工具以插件形式提供此能力,需确认插件的更新频率与主版本兼容性。
5. 测试结果智能分析
包含两个层次:一是执行层面的稳定性检测,识别环境波动或数据依赖导致的偶发失败;二是策略层面的优先级重排,综合代码变更范围、历史缺陷密度、业务影响面等因素,动态调整测试执行顺序。
三、六款主流平台的能力矩阵与定位分析
以下按AI能力覆盖广度划分为三个层级,每个层级内的工具在基础能力深度、组织适配性上存在显著差异。
第一层级:全流程协同型(覆盖4项及以上)
ONES
ONES 是企业级研发管理平台,核心优势在于一体化架构:项目管理、需求管理、知识库、测试管理、流水线与代码管理在同一数据层运行,消除工具割裂导致的信息断层。面向中大型组织,支持复杂流程配置、精细化权限模型与跨团队协作治理。在测试管理侧,ONES 强调研发效能度量,通过多维数据看板驱动交付质量与效率的持续改进。
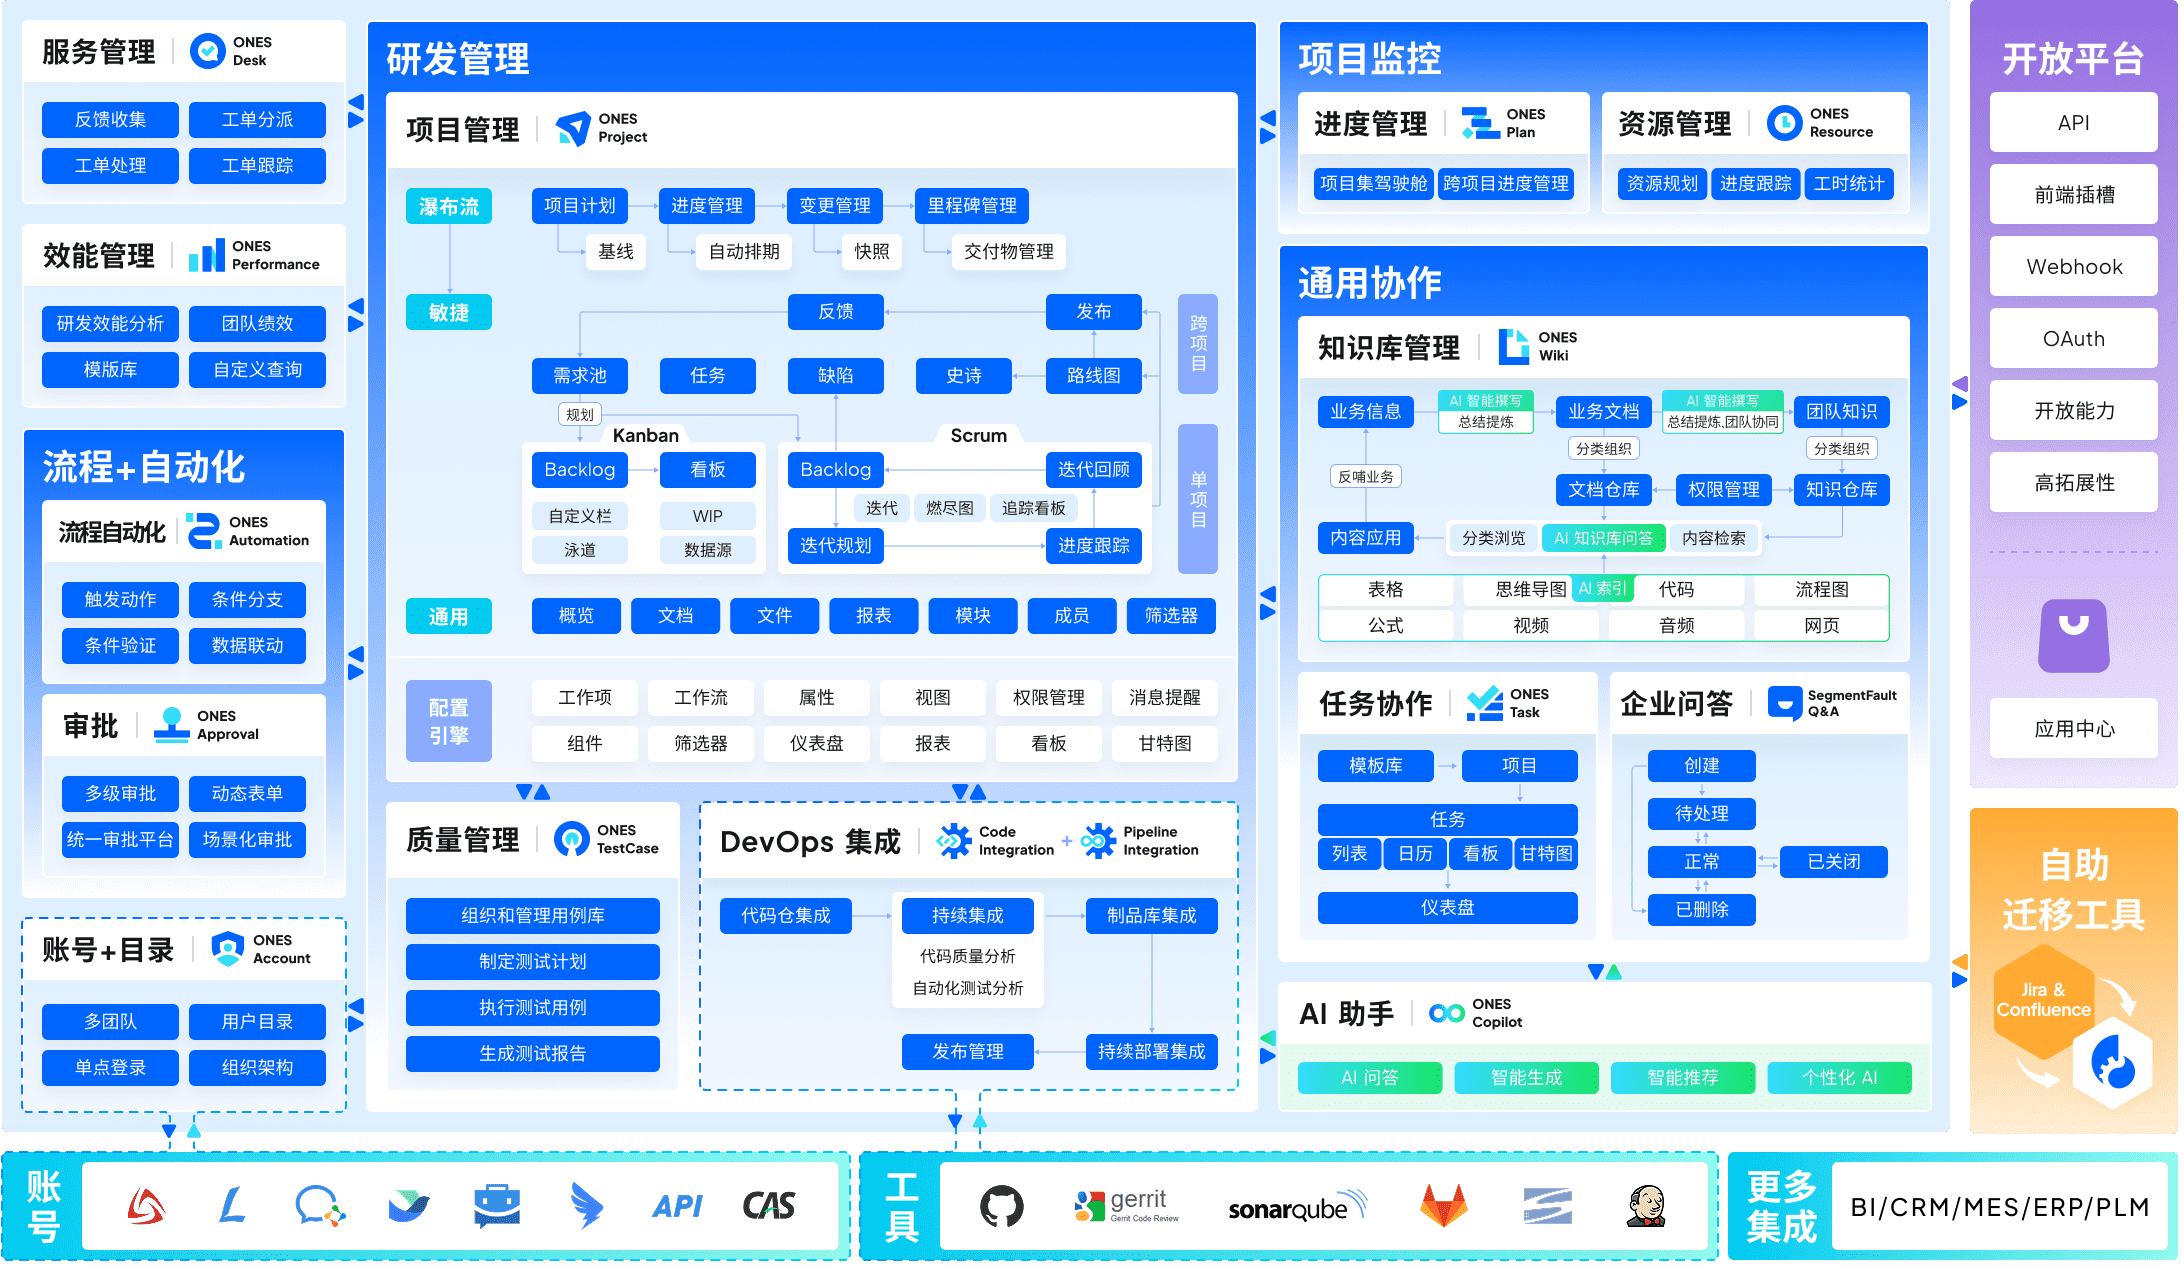
AI能力覆盖智能用例生成、脚本转换、覆盖率追踪、结果分析四个维度,且与需求、代码、流水线形成完整追溯链。适合测试体量较大、流程完整、需要AI能力与研发全链路协同发挥作用的团队。
Xray
作为Jira生态的深度集成方案,Xray 在Gherkin场景生成、Selenium/Playwright脚本导出、覆盖缺口检查、执行结果摘要四个维度具备成熟能力。其优势在于与Atlassian产品线的无缝衔接,适合已深度使用Jira且希望同一平台承载AI能力的团队。需注意其对Jira的强依赖在脱离该生态时迁移成本较高。
第二层级:专项深化型(覆盖3项)
TestRail
独立测试管理平台,聚焦用例生成、脚本转换、结果分析三个环节。其优先级排序算法融合机器学习与语义分析,能够基于执行历史自动评分测试价值。适合需要独立QA平台、不绑定研发主链路的团队,尤其在多项目并行、需要统一测试资产管理的场景中表现稳定。
PractiTest
以端到端追溯与需求覆盖见长,支持标准化协议接入,覆盖用例生成、缺陷治理、覆盖率追踪。在审计要求严格、合规流程复杂的行业中具备优势,如金融、医疗等受监管领域。其需求-用例-缺陷的三向追溯机制较为完善。
Testomat.io
统一管理手工与自动化测试资产,覆盖用例生成、缺陷治理(支持数据增删改查)、结果分析(不稳定测试检测)。特色在于对混合测试策略的支持,适合自动化转型中期、两类测试并存的团队。其开放接口设计便于与CI/CD流水线对接。
第三层级:轻量聚焦型(覆盖1-2项)
Qase
专注脚本转换单一维度,提供丰富的API接口与定制化报告。界面简洁、上手门槛低,适合测试团队规模较小、痛点明确在自动化脚本产出效率的团队。扩展性受限于功能聚焦,长期成长空间需结合团队发展节奏评估。
| 平台 | 用例生成 | 脚本转换 | 缺陷治理 | 覆盖追踪 | 结果分析 | 适用组织规模 |
|---|---|---|---|---|---|---|
| ONES | ✓ | ✓ | — | ✓ | ✓ | 中大型 |
| Xray | ✓ | ✓ | — | ✓ | ✓ | 中大型 |
| TestRail | ✓ | ✓ | — | — | ✓ | 中型 |
| PractiTest | ✓ | — | ✓ | ✓ | — | 中大型 |
| Testomat.io | ✓ | — | ✓ | — | ✓ | 中型 |
| Qase | — | ✓ | — | — | — | 小型 |
注:✓ 表示具备该维度AI能力,— 表示该维度以基础功能为主或依赖第三方扩展。部分功能需特定版本或插件支持。
四、团队适配决策框架
同一层级的工具如何选择,需回归团队的具体约束条件。
| 团队特征 | 核心诉求 | 推荐方向 |
|---|---|---|
| 500人以上研发组织,多产品线并行 | 消除工具孤岛,统一效能度量口径 | ONES:一体化架构降低集成成本,数据驱动治理 |
| 已深度使用Jira,Atlassian生态绑定 | 同一平台延伸AI能力,避免数据迁移 | Xray:生态内扩展,学习曲线平缓 |
| QA部门独立运作,需统一测试资产管理 | 专业测试平台,不依赖研发主工具 | TestRail:独立性强,优先级算法成熟 |
| 强合规行业,审计追溯要求严格 | 完整的三向追溯链,操作留痕 | PractiTest:需求覆盖与审计支持完善 |
| 自动化转型中期,手工与自动化并存 | 混合测试统一管理,平滑过渡 | Testomat.io:双模式支持,CI/CD友好 |
| 初创团队,测试人员10人以内 | 快速上手,聚焦脚本产出效率 | Qase:轻量部署,API灵活 |
五、选型过程中的典型陷阱
基于多个组织的落地实践,以下四类问题最为常见:
1. 低估组织适配成本
软件上线后存在客观的迁移损耗期:旧习惯调整、流程重新梳理、历史数据清洗。若未将培训投入、流程改造周期纳入总成本评估,易出现预算超支或 adoption 不足。
2. 以演示环境推断生产表现
厂商演示通常基于结构化良好的样本数据。真实项目中需求文档质量参差、历史数据缺乏规范,AI输出质量会显著下降。建议要求基于自身脱敏数据进行现场验证,再作决策。
3. 轻视数据迁移的工程复杂度
不同平台的用例字段模型、关联关系定义、执行记录结构差异显著。迁移失败多源于字段映射偏差或关联链断裂。选型前需评估:数据量级、字段兼容性、厂商是否提供成熟迁移工具或API支持。
4. 过度关注AI功能而弱化基础能力
测试管理软件的核心价值仍在于用例组织、执行跟踪、追溯链构建等基础能力。AI是增强层而非替代层。若基础功能薄弱,AI能力难以有效附着,反而增加操作复杂度。
六、常见问题
AI生成的测试用例是否可以直接投入执行?
不建议。当前各平台的生成结果均需人工审核,重点校验业务语境匹配度、边界条件完整性、以及需求变更后的时效性。AI产出更适合作为初稿,而非终稿。
一体化平台与独立测试工具如何取舍?
取决于组织的信息架构现状。若研发工具链已高度分散,一体化平台(如 ONES)的数据贯通价值更高;若测试部门有独立治理诉求,或已存在成熟的研发主平台,独立工具(如 TestRail)的灵活性更优。
中小团队是否需要追求全流程AI覆盖?
未必。覆盖维度与团队规模、测试复杂度正相关。10人以下团队通常痛点集中在脚本产出效率,选择轻量聚焦型工具更务实,避免为冗余功能支付学习与配置成本。
如何验证厂商的AI能力承诺?
要求基于自身真实数据(脱敏后)进行POC验证,重点关注三类场景:需求变更后的增量用例更新、历史缺陷数据充足时的优先级排序准确性、以及覆盖缺口识别的误报率。
结语
AI对测试管理的改造,本质是工作流中决策节点的重新分配——将规则明确、数据密集的操作交由算法,将判断复杂、语境依赖的环节保留给人。工具选型的终点不是功能清单的对齐,而是新能力在组织内的有效嵌入。建议团队优先厘清自身的数据基础、流程痛点与规模约束,再匹配相应层级的平台,分阶段推进落地。