400-188-1518
2026年测试管理软件选型指南:AI辅助测试的落地路径与工具对比
测试管理软件的选型逻辑在2026年已经发生了实质性转变。AI生成用例、智能优先级排序、自动化脚本转换等功能逐渐成为标配,但实际落地效果差异显著:部分工具生成的用例与业务场景脱节,需求变更后仍需人工逐条修正;部分工具的分析维度局限于Bug数量统计,高风险模块识别仍需依赖人工翻阅历史数据。
本文梳理了六款主流测试管理软件,从AI辅助测试的五个核心维度展开对比,帮助团队找到与自身规模、流程成熟度相匹配的选型方案:
- ONES
- Xray
- TestRail
- PractiTest
- Testomat.io
- qTest
一、AI辅助测试的五个关键维度
从手工测试向AI辅助测试过渡,核心变化集中在五个环节。理解这些维度的技术实现与业务价值,是选型前的必要准备。
1. AI生成用例
通过解析需求文档自动输出结构化测试用例草稿,包含前置条件、操作步骤、预期结果等标准字段。测试人员承担审核与微调角色,而非从零编写。该能力对需求文档的完整度和规范性有较高依赖。
2. AI脚本转换
将手工测试用例自动转化为可执行的自动化脚本,支持导出至主流测试框架。核心价值在于降低自动化测试的技术门槛,减少重复性编码工作。
3. AI驱动的缺陷管理
通过CLI接口或技能插件,以自然语言指令完成Bug的查询、创建、状态更新与关闭操作,并自动维护需求-用例-Bug之间的追溯关系。
4. 智能覆盖率追踪
替代传统Excel矩阵的手工维护方式,自动识别需求变更引发的覆盖缺口,标记不一致项并提示补全。
5. 测试结果智能分析
涵盖两个层面:一是检测不稳定测试(Flaky Tests)并提供数据修复建议;二是基于执行历史、代码影响面与风险权重对测试优先级进行动态排序,将有限资源集中于高价值验证环节。
二、六款软件AI能力矩阵对比
以下按AI覆盖维度数量将六款软件划分为三个层级,便于快速定位适配区间。
第一层级:全链路覆盖型(4-5个维度)
ONES
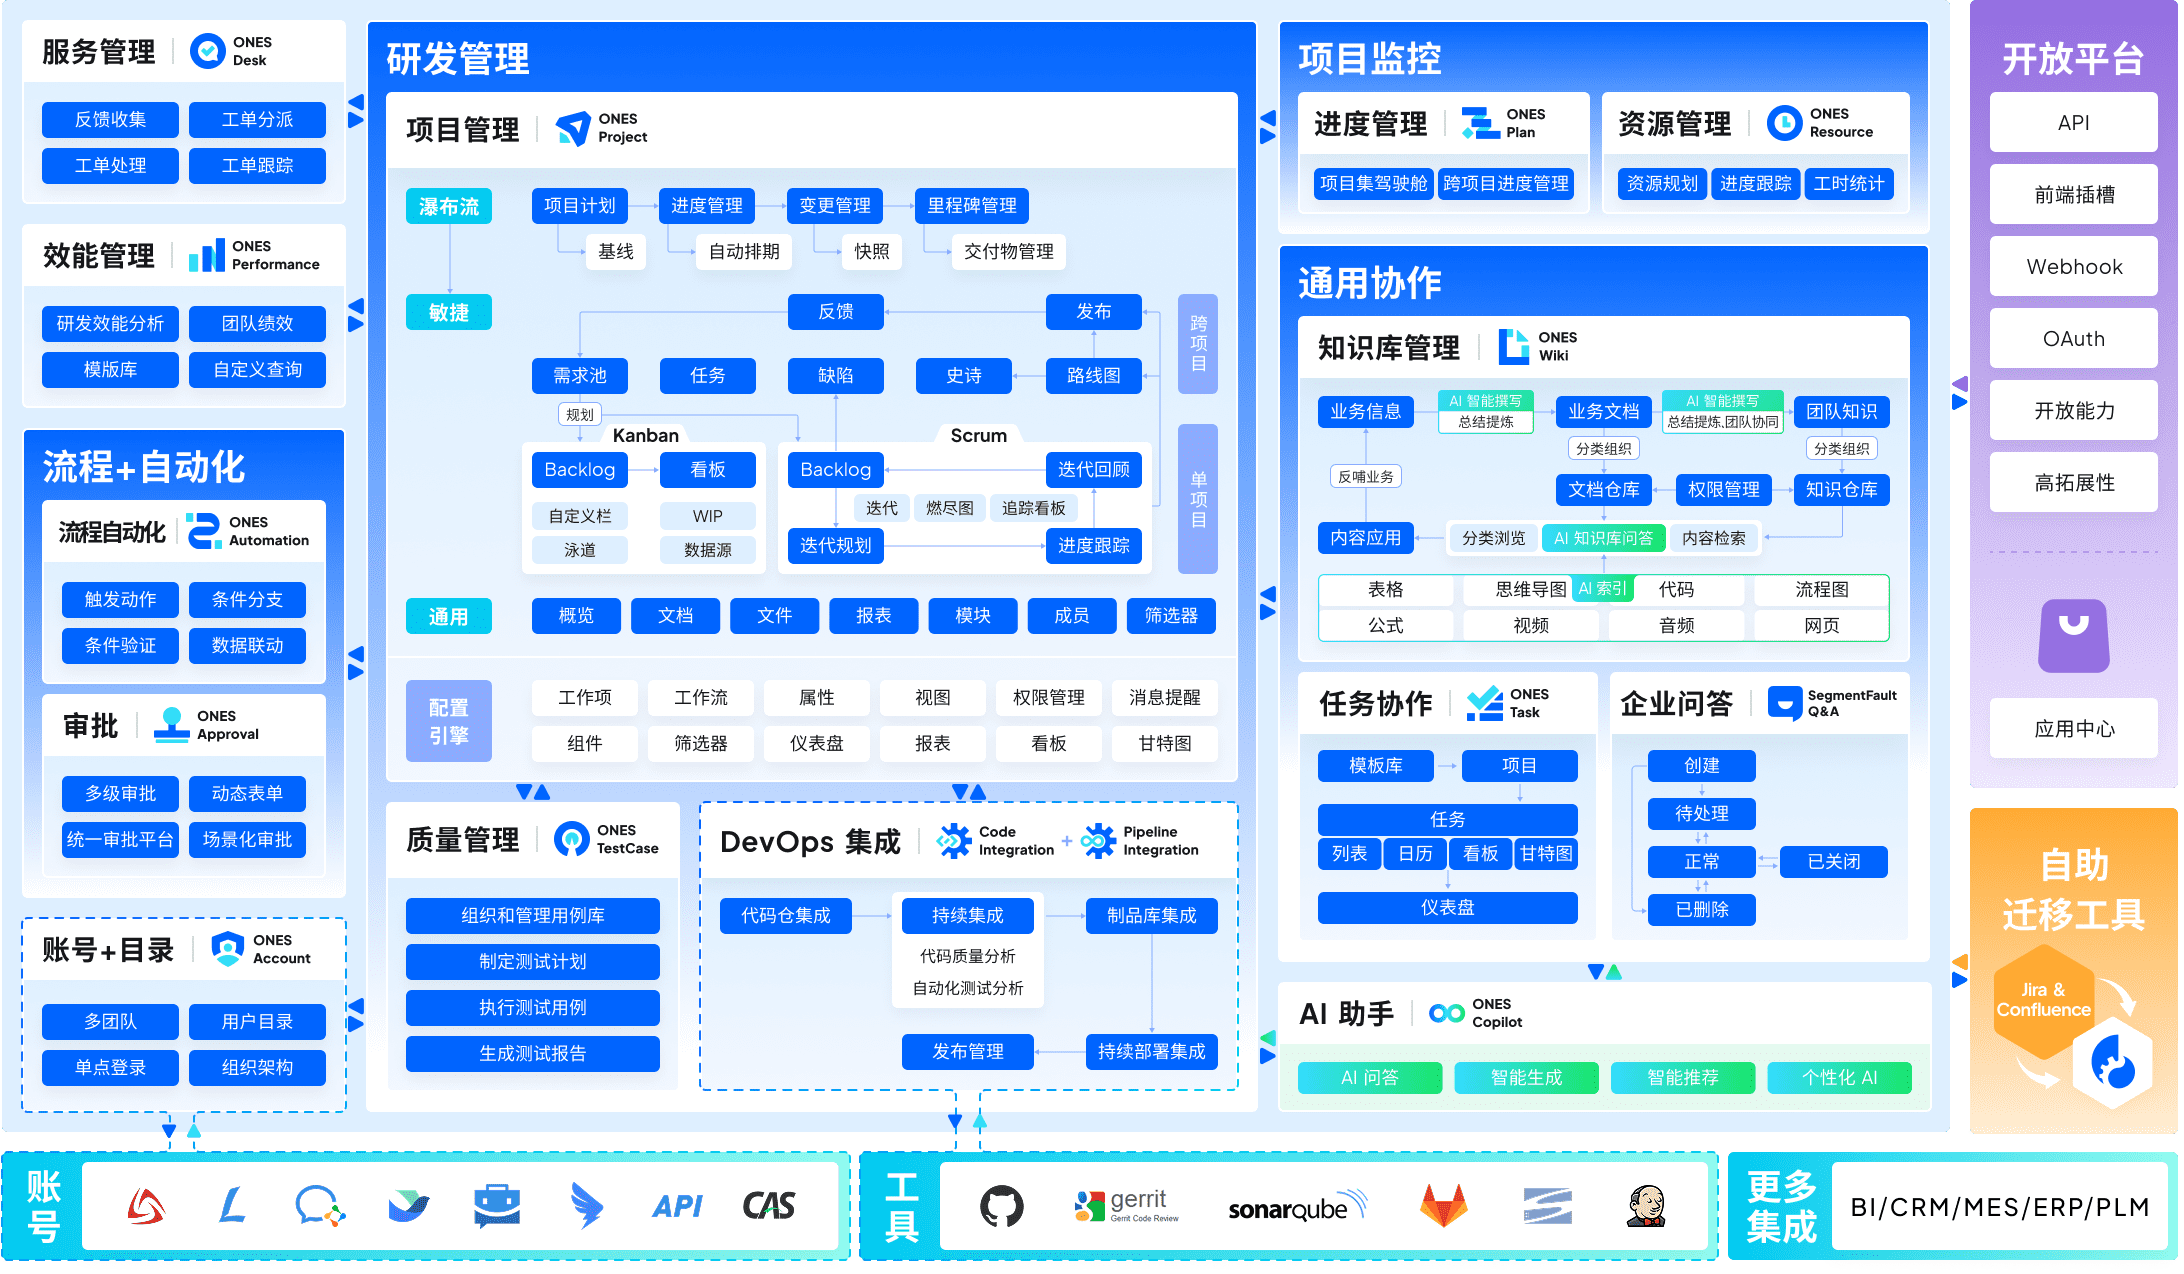
ONES 是企业级研发管理平台,核心优势在于一体化架构:项目管理、需求管理、知识库、测试管理、流水线与代码管理在同一平台贯通,消除工具割裂带来的数据断层。面向中大型组织,支持复杂流程配置、精细化权限模型与跨团队协作治理。在测试管理领域,ONES 强调研发效能度量,通过数据驱动交付质量与效率的持续改进。
AI能力覆盖用例生成、脚本转换、缺陷管理、覆盖率追踪、结果分析五个维度,适合测试规模较大、流程完整、追求端到端数字化治理的团队。
Xray
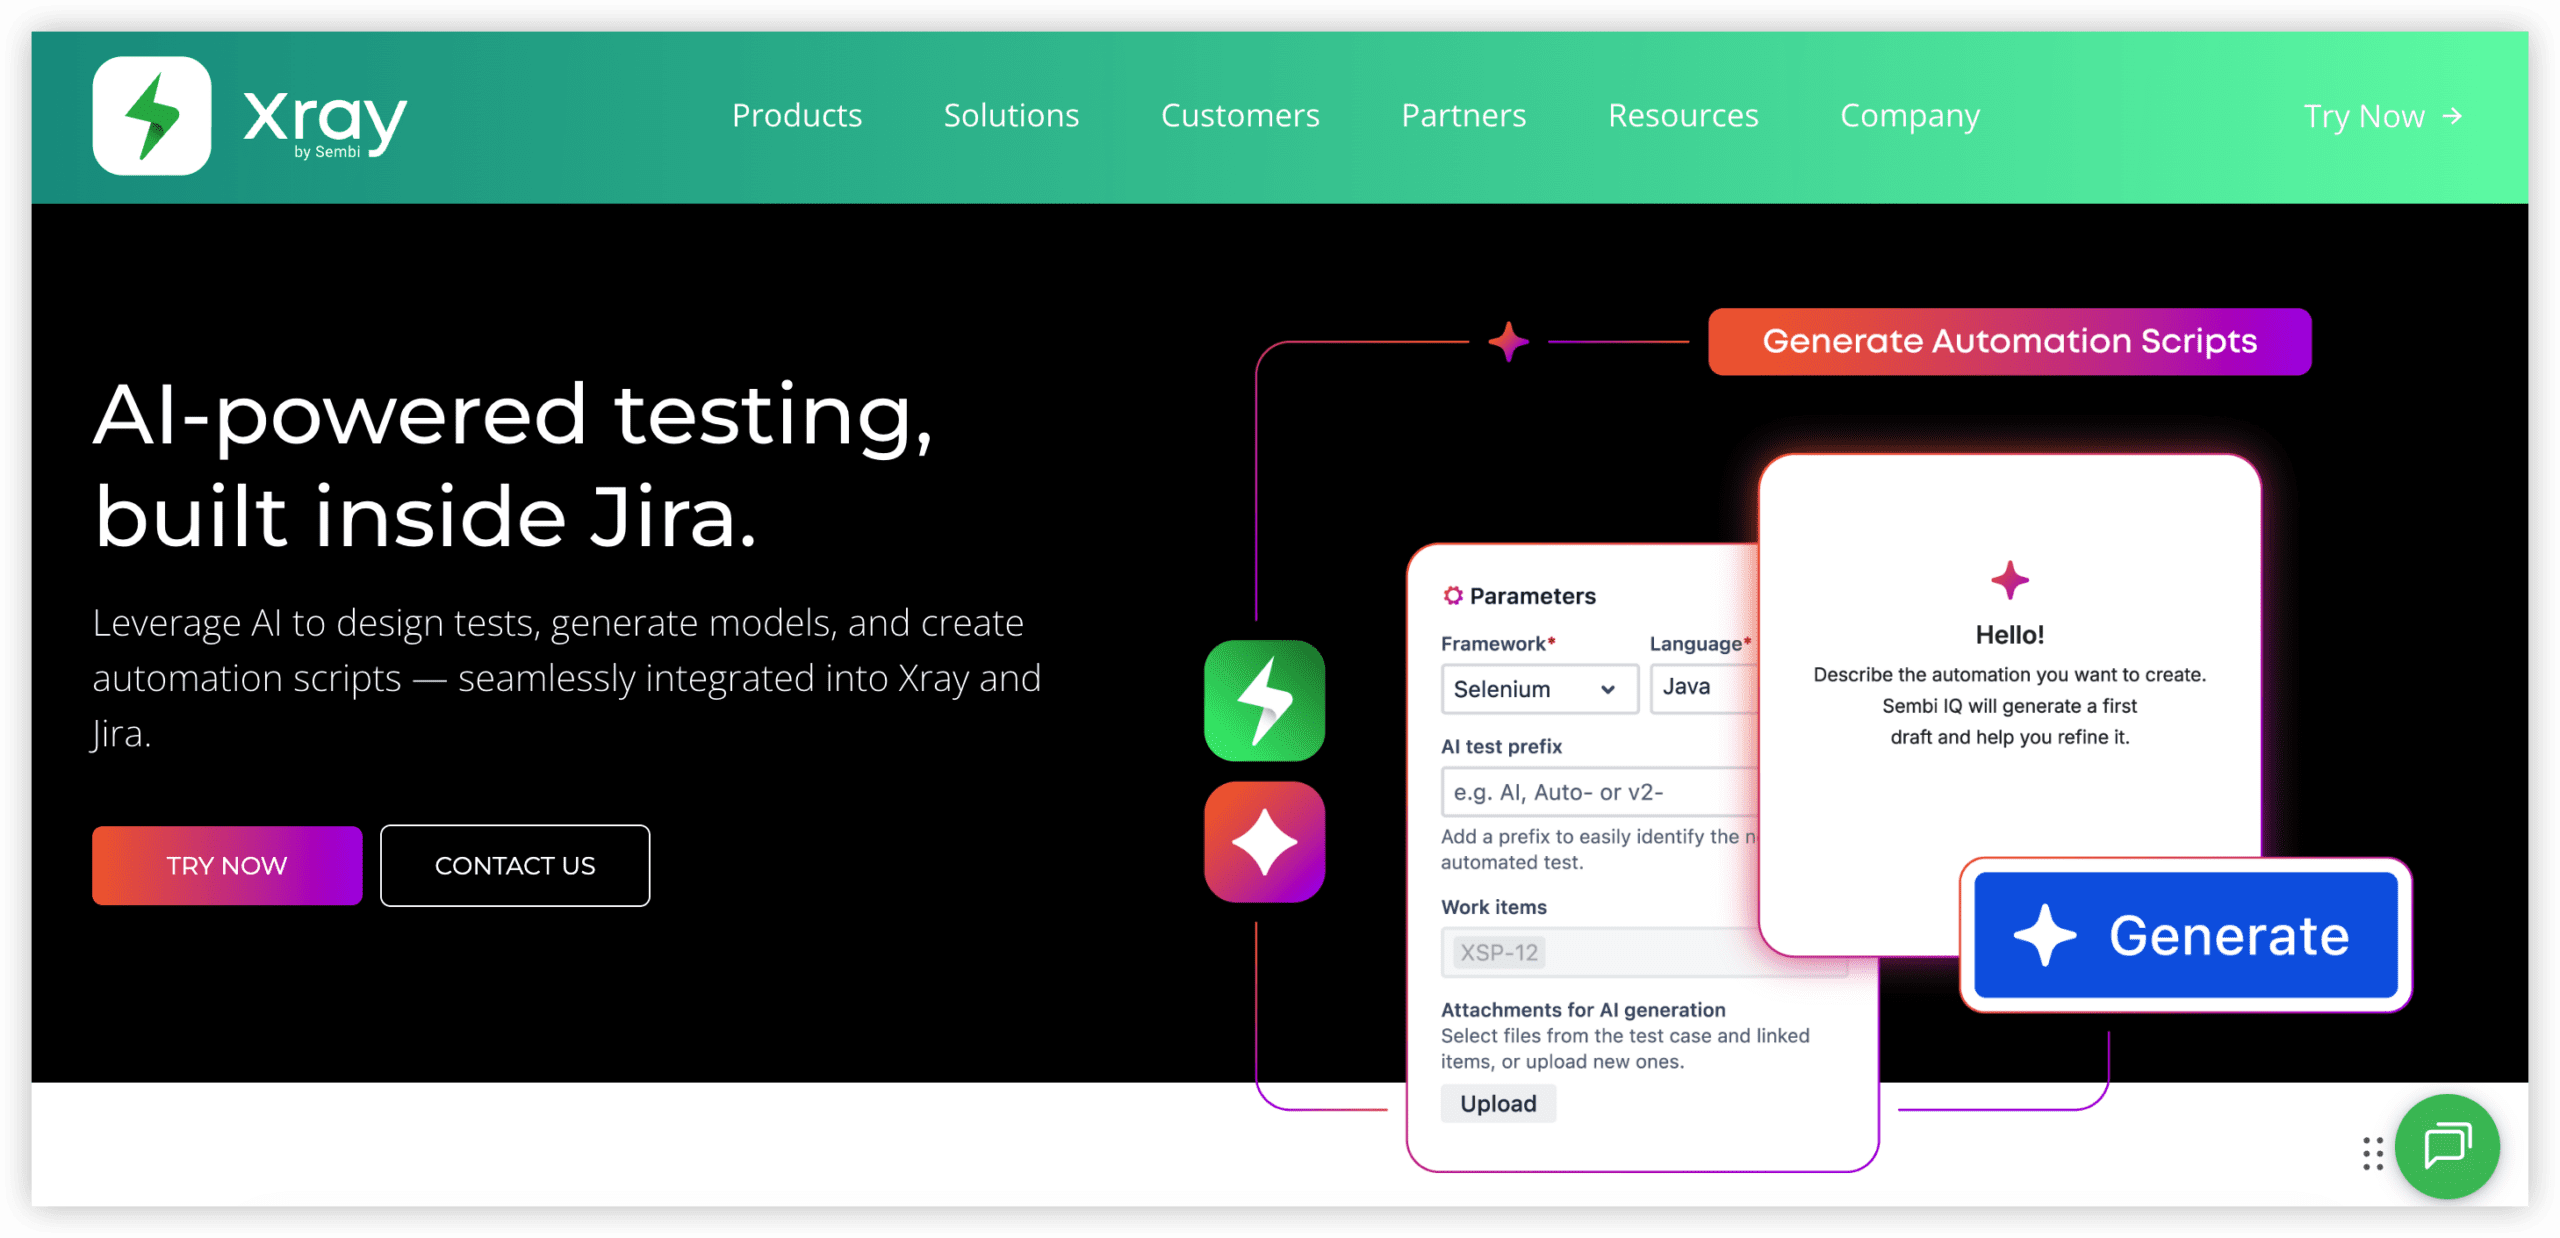
作为Jira生态的深度集成测试管理工具,Xray 在四个维度部署AI能力:Gherkin格式用例生成、Selenium/Playwright脚本导出、覆盖缺口检测、基于Rovo的测试结果摘要与优先级排序。适合已采用Atlassian技术栈、希望在同一协作平台内完成测试活动的团队。
第二层级:核心环节覆盖型(3个维度)
TestRail
独立测试管理平台,聚焦AI用例生成、脚本转换、结果分析三个环节。其优先级排序机制融合机器学习与语义分析,能够依据执行历史自动评分。适合需要脱离Jira生态、构建独立QA中枢的团队。
PractiTest
以端到端追溯与需求覆盖审计见长,支持MCP协议对接。AI能力分布于用例生成、缺陷管理、覆盖率追踪三个维度。适合QA流程复杂、合规审计要求严格的组织。
Testomat.io
统一管控手工测试与自动化测试,AI覆盖用例生成、缺陷管理(MCP协议下的增删改查)、不稳定测试检测三个维度。适合混合测试模式占比高、追求统一管理视图的团队。
第三层级:场景聚焦型(1-2个维度)
qTest
Tricentis旗下企业级平台,AI能力集中于用例生成与缺陷分析管理两个维度,通过API的aiGeneratedSource字段标识AI生成内容来源。适合大型企业、多测试团队并行或组织级质量治理场景。
三、团队适配速查矩阵
| 团队规模与特征 | 核心痛点 | 选型侧重 |
|---|---|---|
| 中大型组织,多产品线并行 | 工具分散,数据孤岛,跨团队协作成本高 | 优先评估一体化平台,关注流程配置灵活性与效能度量能力 |
| 已深度使用Jira | 测试活动与项目管理脱节 | 考虑生态内深度集成方案,降低切换成本 |
| 独立QA部门,审计合规严格 | 需求-用例-缺陷追溯链不完整 | 侧重端到端追溯与覆盖审计能力 |
| 自动化转型初期,手工测试占比高 | 自动化脚本编写门槛高,维护成本大 | 关注脚本转换成熟度与混合测试支持度 |
| 大型企业,多测试团队 | 缺乏统一质量标准与治理视图 | 考察组织级权限模型与AI生成内容溯源机制 |
四、选型常见误区
1. 低估实施成本
工具上线伴随流程迁移与习惯重塑,效率折损期客观存在。选型需将培训周期、流程适配工作量纳入总拥有成本,而非仅对比功能清单。
2. 过度依赖演示环境
演示场景中AI表现通常基于高质量输入数据。真实项目的需求文档质量参差、历史数据混乱,实际效果可能显著缩水。建议以试点项目验证而非直接全量推广。
3. 忽视数据迁移风险
不同工具的用例字段定义、关联关系模型、执行记录结构差异显著。迁移失败多源于字段不兼容或关联丢失。选型前需评估存量数据规模、格式兼容性及官方迁移工具成熟度。
4. 重AI轻基础
AI功能应建立在扎实的测试管理底座之上。用例版本控制、执行跟踪粒度、需求追溯链完整性等基础能力,直接决定AI输出的可用性。建议优先验证基础功能,再评估AI增强价值。
五、FAQ:选型决策中的高频问题
Q1:一体化平台与独立测试工具如何选择?
取决于现有技术债务与组织复杂度。若研发工具链已高度分散,一体化平台的集成收益高于功能深度;若测试团队具备独立运维能力且对特定环节有极致要求,独立工具可能更适配。
Q2:AI生成用例能否替代测试人员?
当前阶段AI输出仍需人工审核与业务校准,其价值在于压缩重复性编写时间,而非完全替代。测试人员的领域知识与场景判断仍是质量保障的关键。
Q3:如何评估AI能力的真实水平?
建议以本团队真实需求文档为输入,对比各工具生成用例的业务匹配度、边界条件覆盖完整度、以及需求变更后的更新响应效率,避免以通用Demo作为决策依据。
Q4:小型团队是否需要追求全维度AI覆盖?
未必。测试体量有限时,聚焦痛点环节的精准投入,通常比追求全链路覆盖更具性价比。优先识别当前最大时间损耗点,选择对应维度能力突出的工具。
结语
AI对测试管理的改变,本质上是工作流嵌入方式的重组,而非功能的简单叠加。工具价值的兑现程度,取决于与团队现有流程、数据基础、组织能力的耦合深度。
选型决策的合理路径是:先诊断团队核心痛点与数据就绪度,再确定所需的AI覆盖层级,最后在对应层级中评估具体产品的基础能力与扩展空间。功能清单的对勾数量,不应成为首要决策依据。