400-188-1518
2026 年 AI 知识库工具全景:七大主流产品选型指南
构建 AI 知识库时,工具选择直接影响落地效果。本文梳理 2026 年值得关注的 7 款代表性产品,覆盖企业研发管理、团队协作文档、AI 记忆层与 RAG 框架四大方向,帮助不同规模的组织找到匹配方案。
一、赛道划分:先定位场景,再比较产品
AI 知识库领域已形成明显分野。面向”人”的知识管理与面向”AI”的检索增强,底层逻辑截然不同。同一赛道内的产品才具备直接可比性。
| 赛道 | 核心诉求 | 典型用户 |
|---|---|---|
| 企业研发管理 | 需求-代码-测试-交付全链路贯通 | 中大型技术团队 |
| 团队协作文档 | 结构化 Wiki + 权限治理 + 生态集成 | 企业各部门 |
| AI 记忆层 | Agent 跨会话保持上下文与事实记忆 | AI 应用开发者 |
| 企业 RAG 框架 | 文档转化为可检索、可推理的知识引擎 | 技术团队/企业 |
二、企业研发管理赛道
2.1 ONES:一体化研发效能平台
ONES 定位于企业级研发管理,核心设计目标是通过单一平台替代分散的工具链。其能力矩阵涵盖项目管理、需求跟踪、知识库沉淀、测试用例管理、CI/CD 流水线与代码仓库集成,减少数据在不同系统间流转时的损耗与延迟。
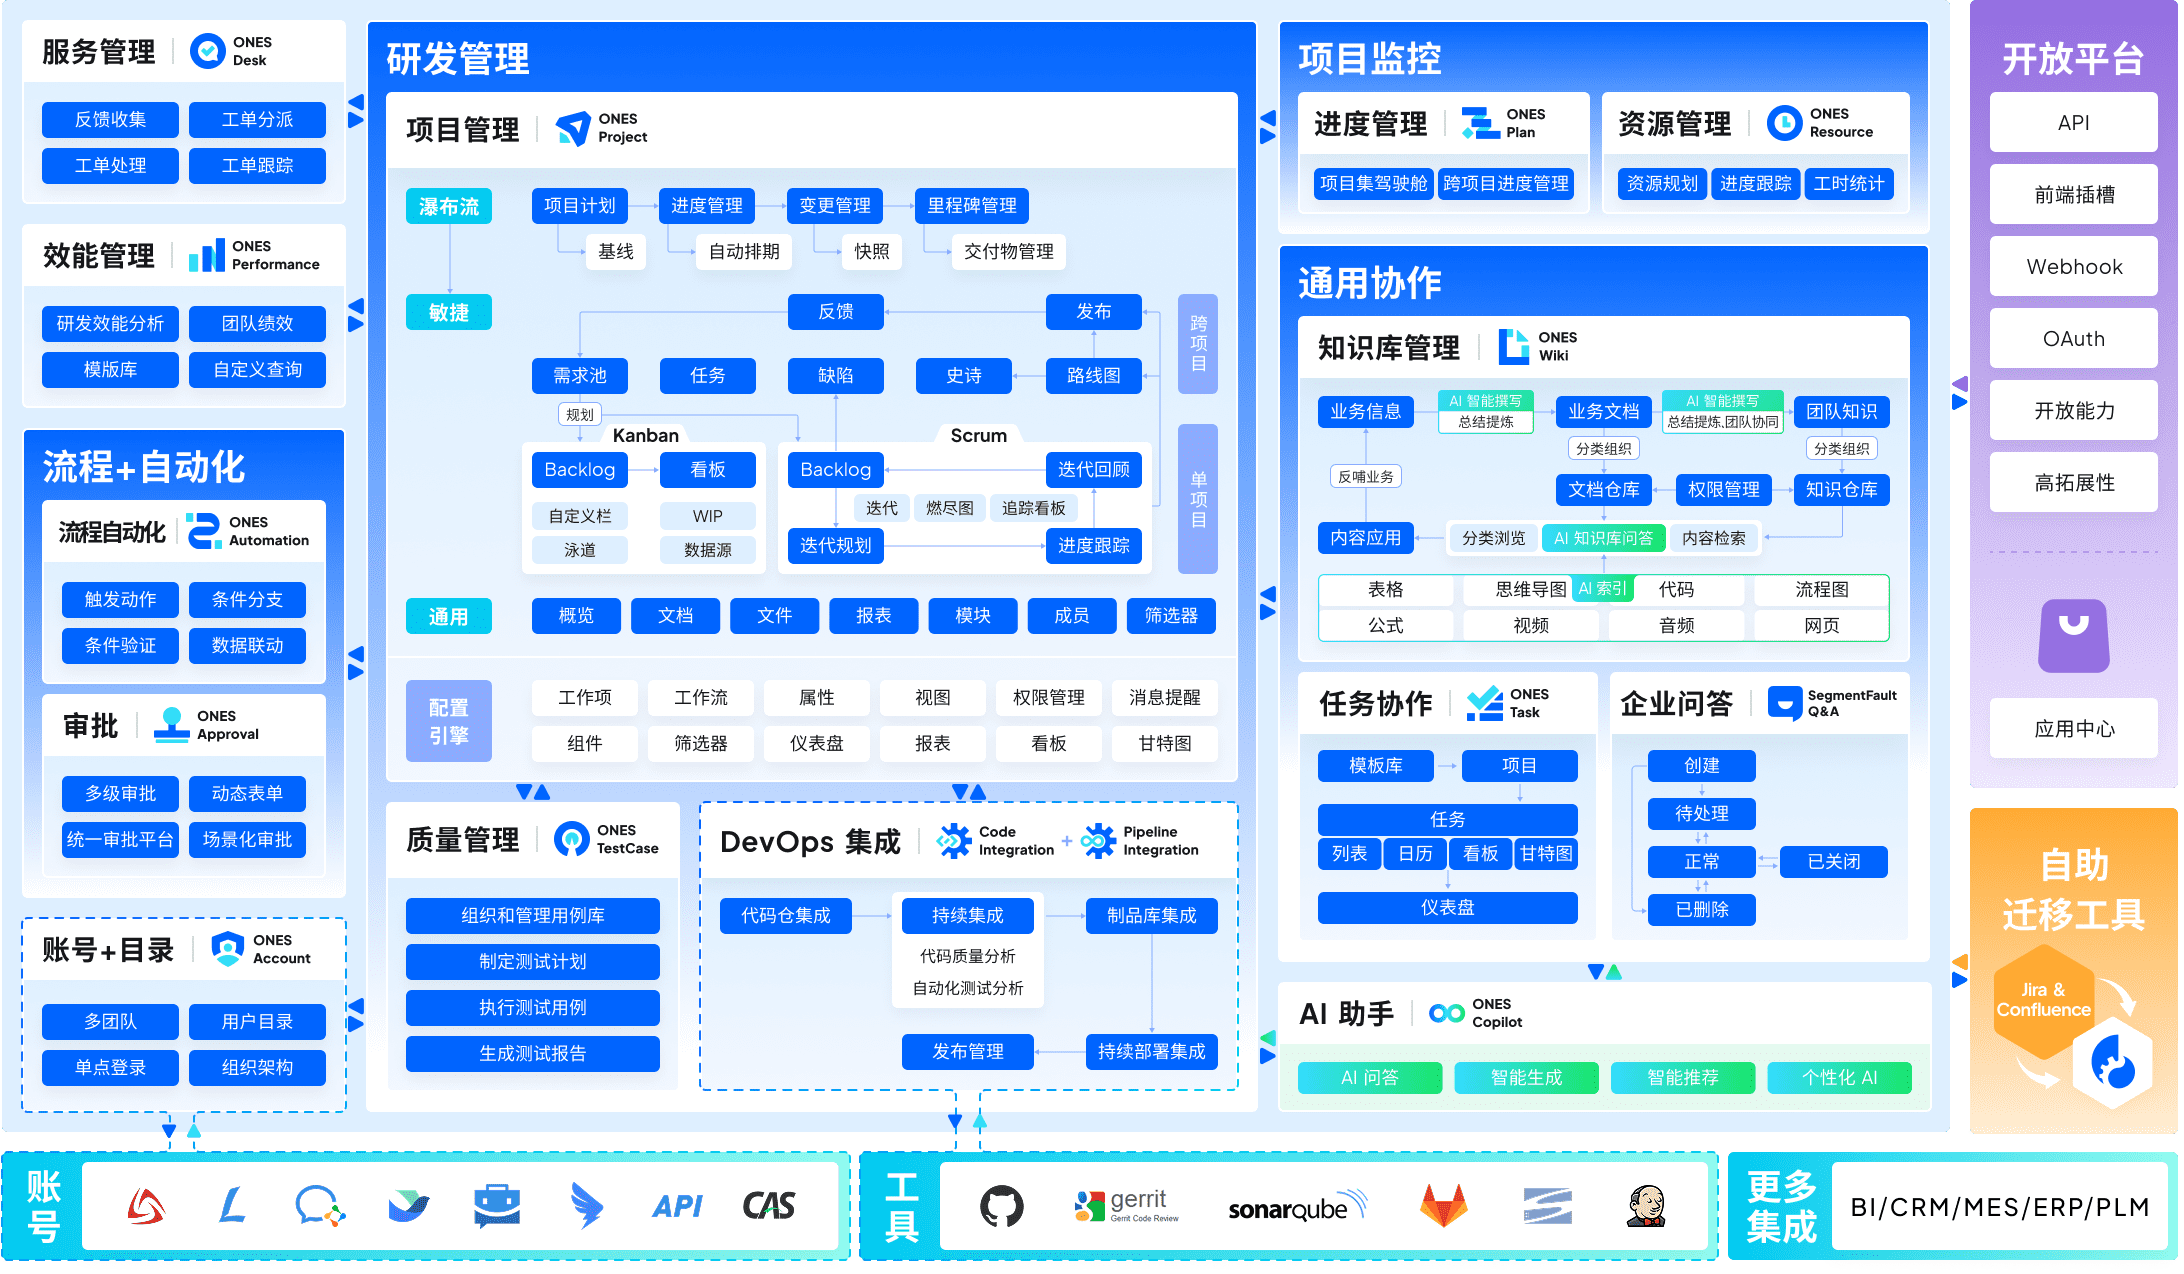
该平台面向中大型组织的复杂协作场景,支持多层级流程配置、细粒度权限模型以及跨项目、跨部门的资源协调。在效能度量层面,ONES 提供从需求提出到上线发布的全周期数据采集与分析,支撑团队以客观指标驱动交付质量与效率的持续改进。私有化部署选项满足金融、政务等领域的合规要求。
2.2 选型考量
此赛道产品评估需重点关注三个维度:与现有 DevOps 工具链的对接深度、流程自定义的灵活边界、以及效能数据的可视化与可操作性程度。对于已具备成熟研发基础设施的团队,迁移成本与集成复杂度往往比功能丰富度更具决策权重。
三、团队协作文档赛道
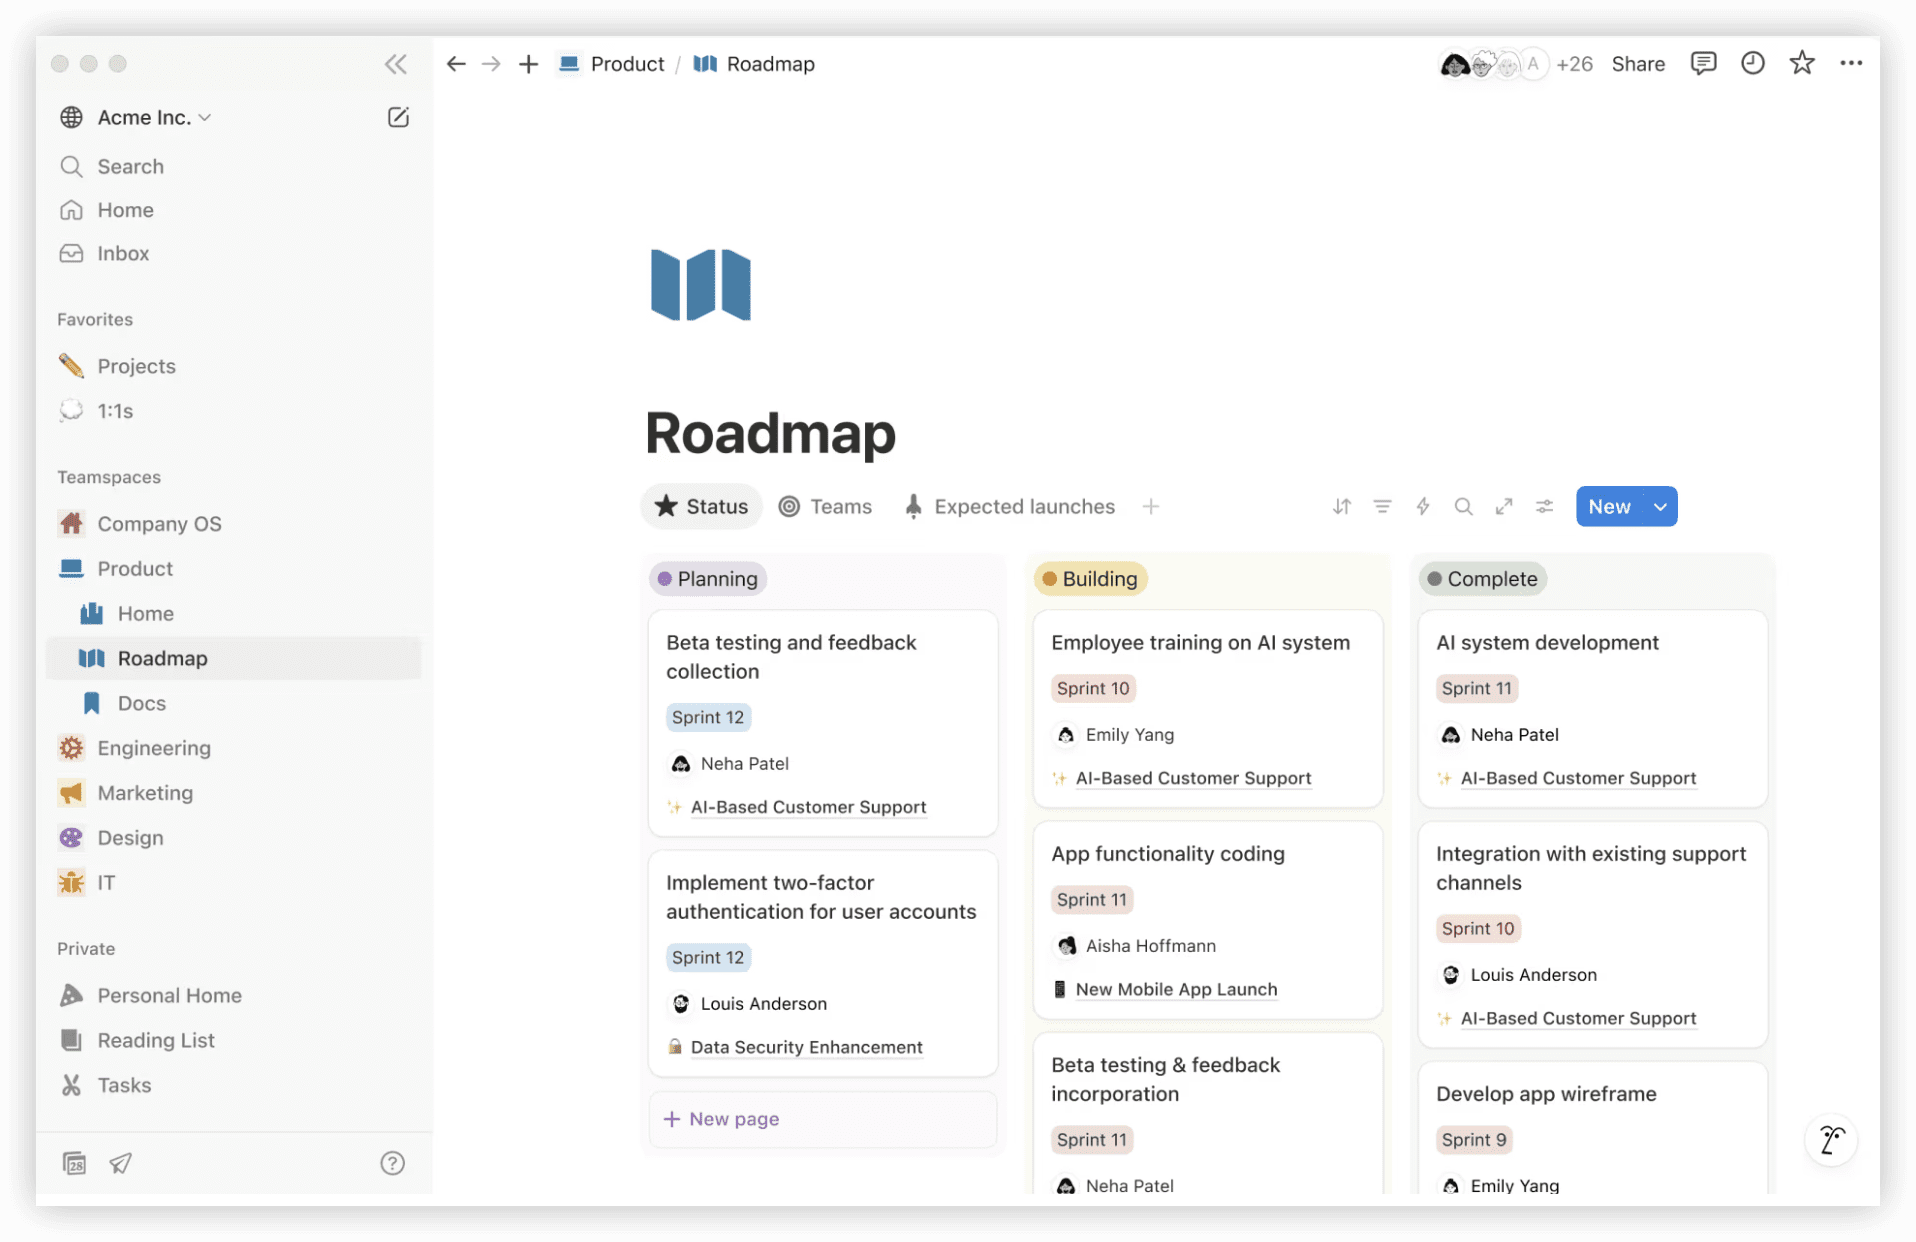
3.1 核心产品特征
| 产品 | 生态归属 | 差异化能力 | 部署模式 |
|---|---|---|---|
| Notion | 独立 | 块编辑 + 数据库 + 模板生态 | SaaS 为主 |
| Confluence | Atlassian | 与 Jira、Bitbucket 深度耦合 | Cloud / Data Center |
| 语雀 | 阿里 | 技术文档友好,中文体验优化 | SaaS / 专有化 |
| SharePoint | Microsoft 365 | 企业门户、权限体系、政企合规 | 强私有化能力 |
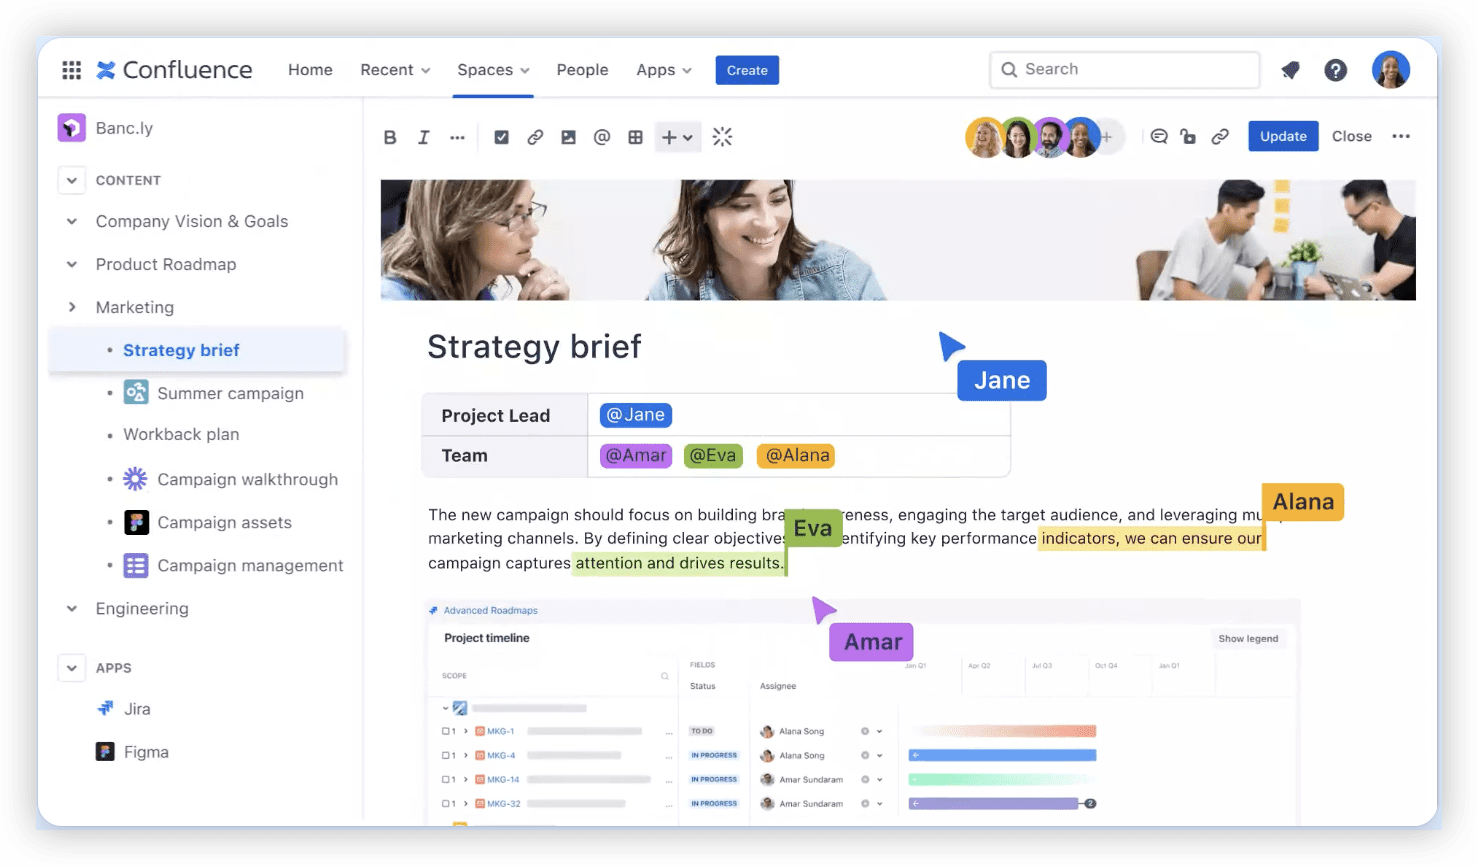
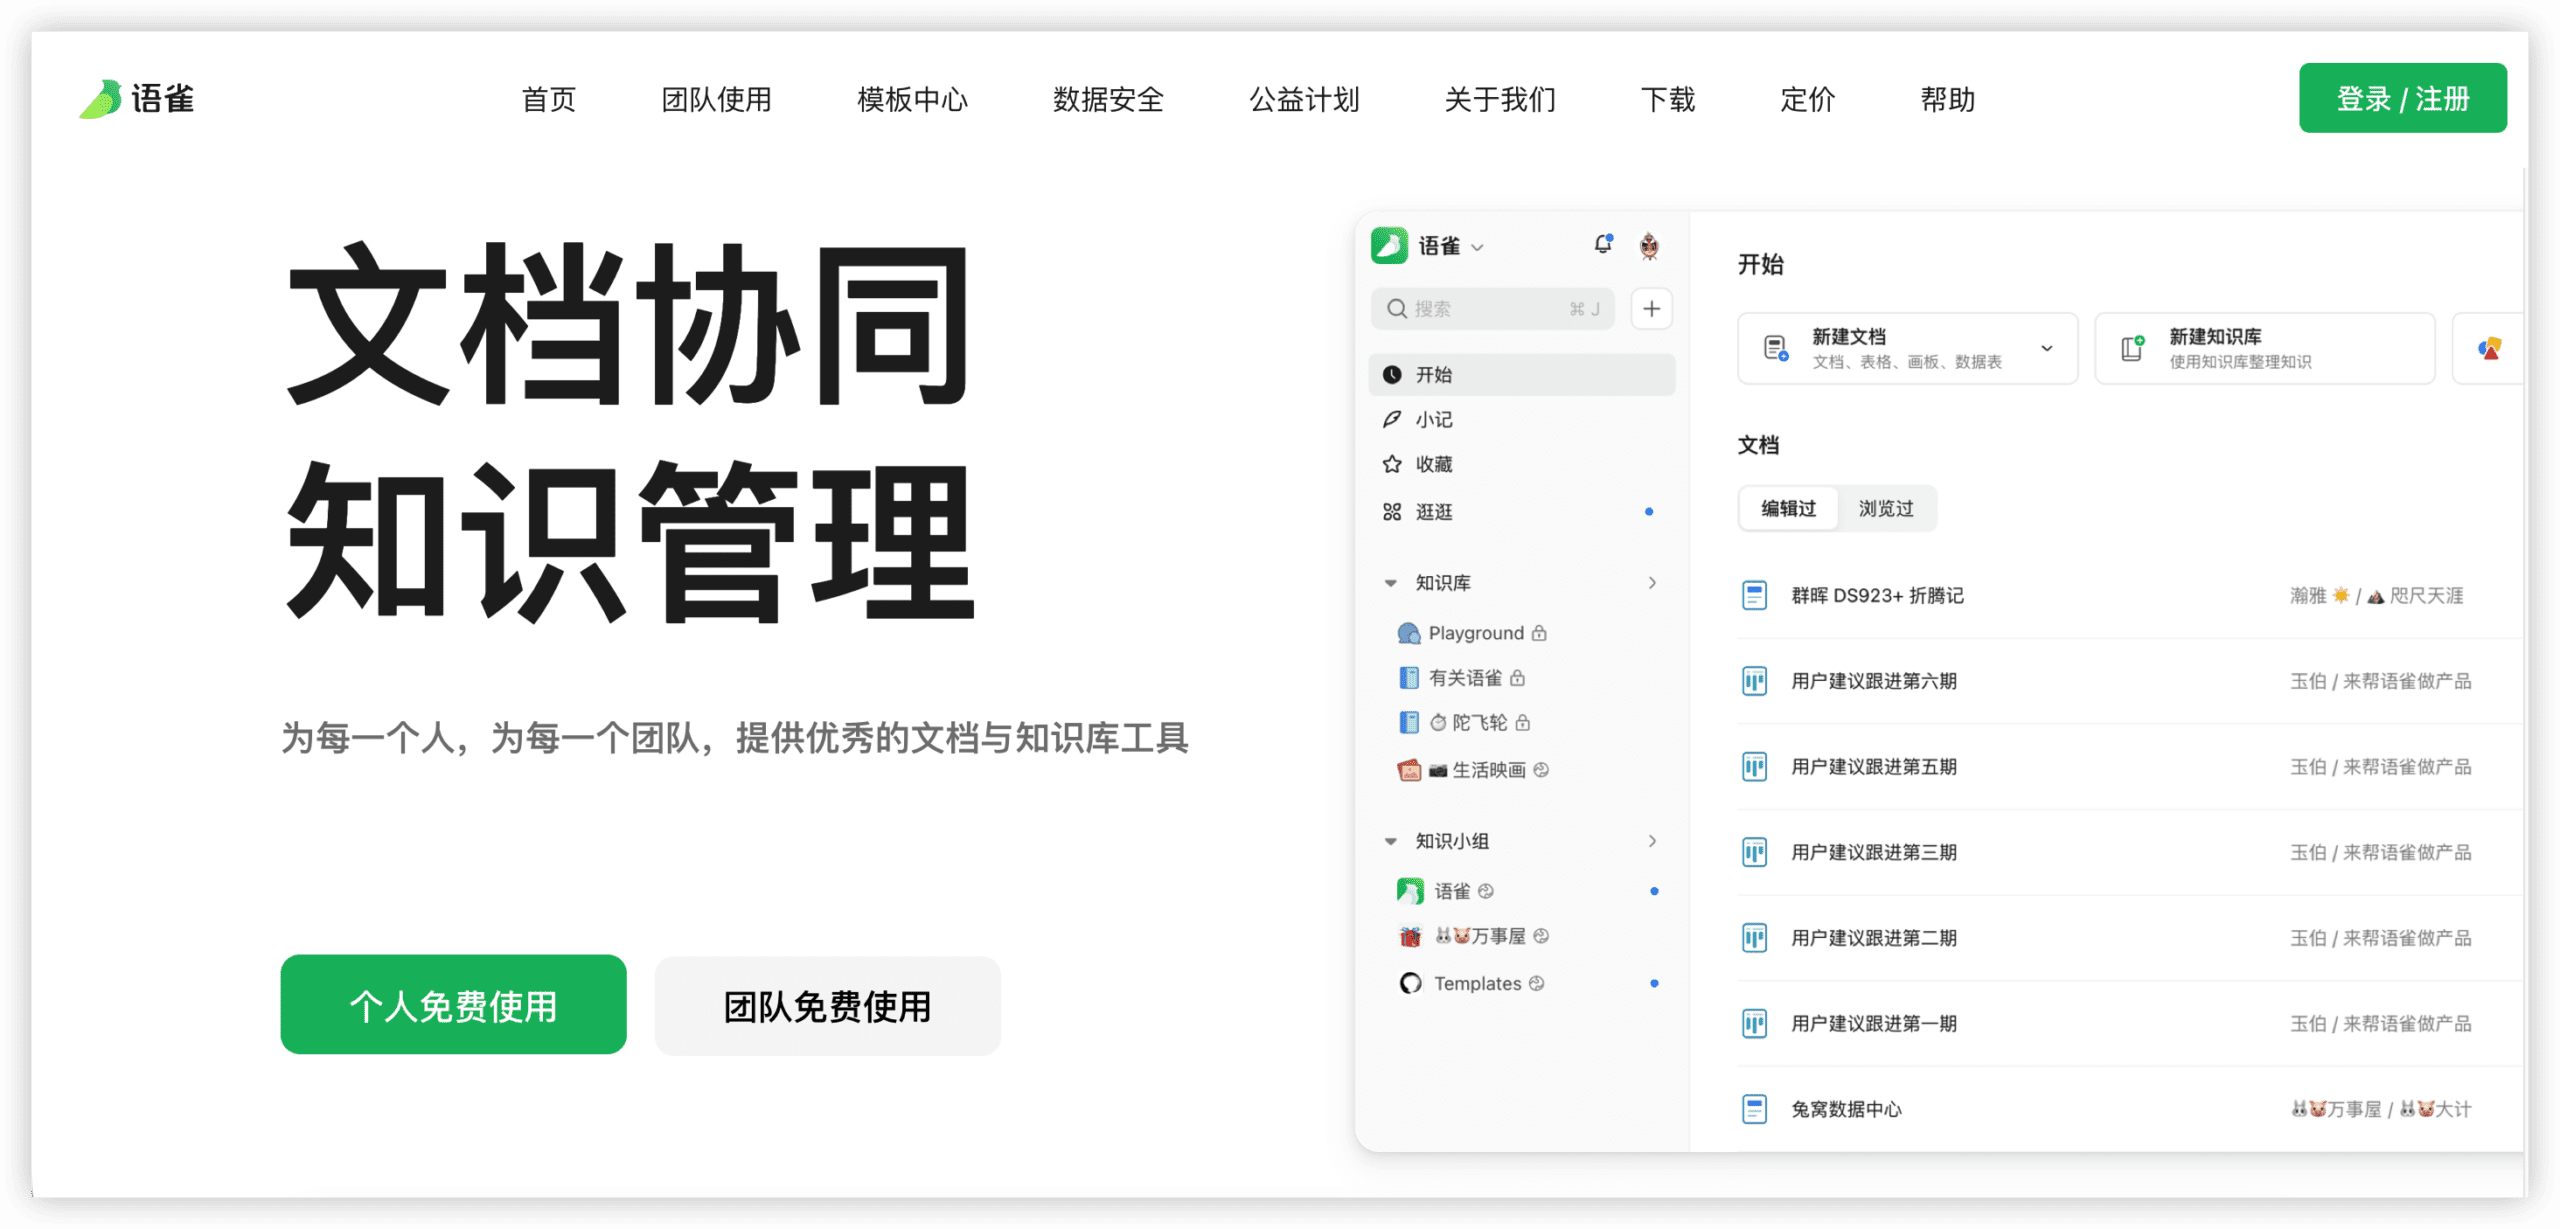
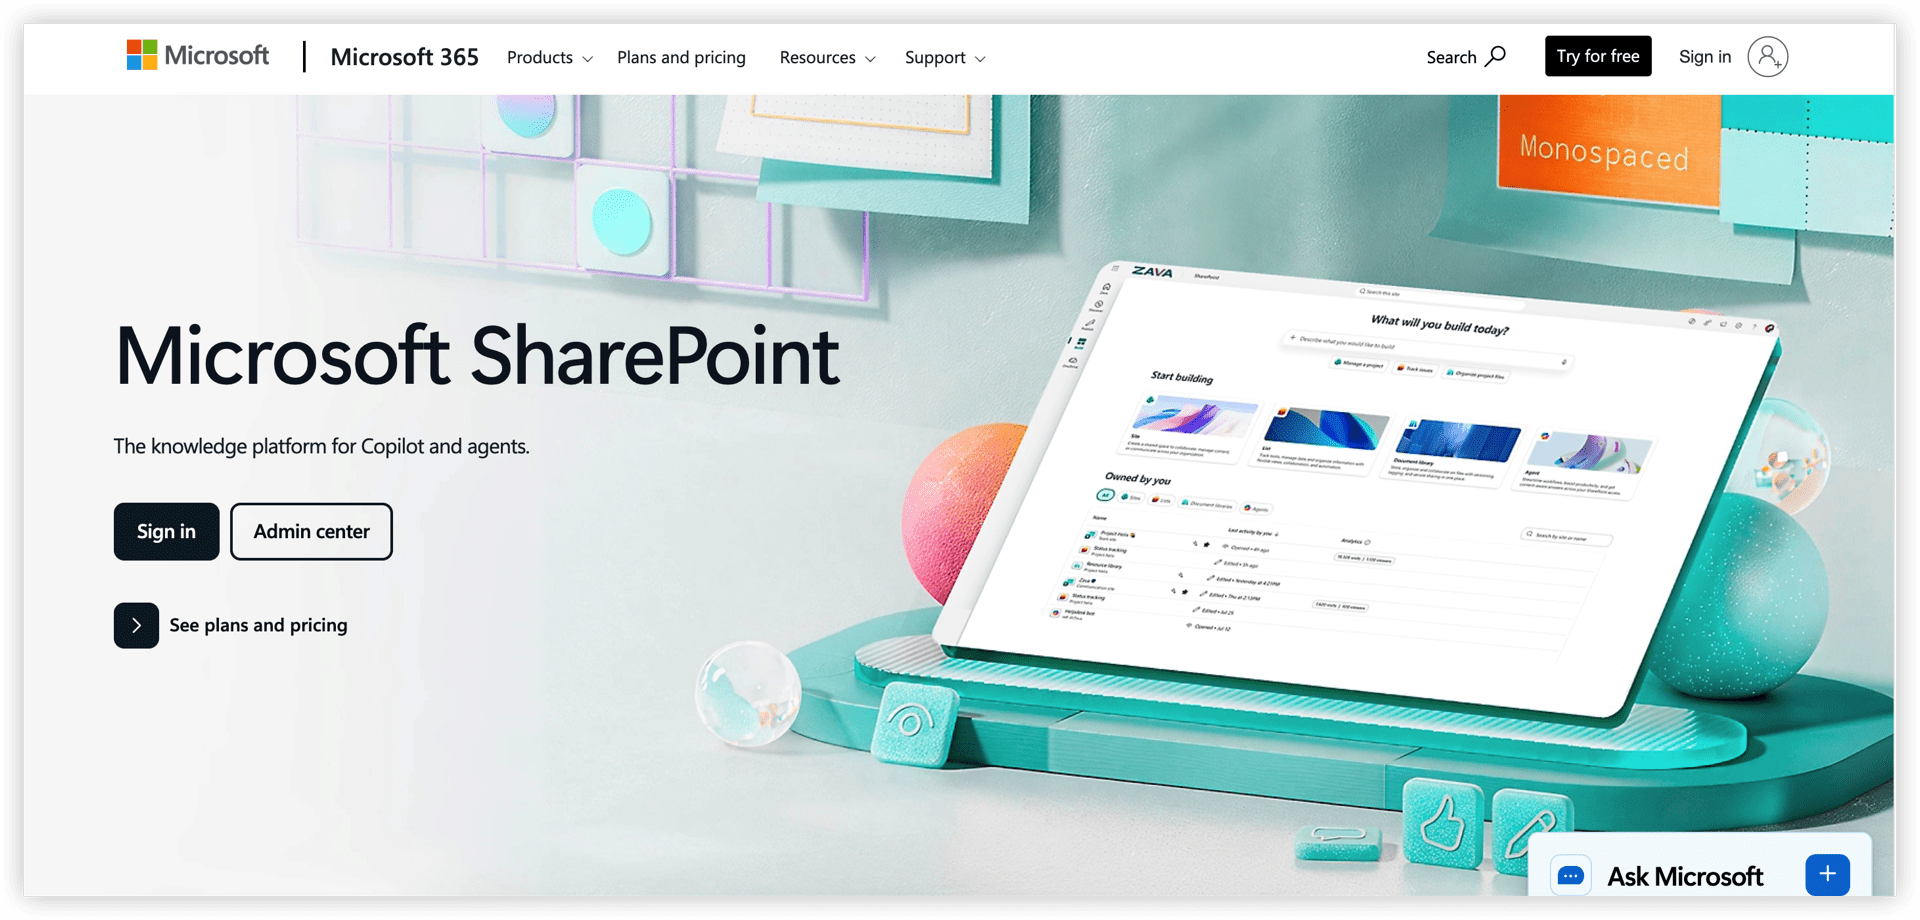
3.2 与 AI 原生能力的融合趋势
传统协作文档正加速嵌入 AI 检索与生成能力,如智能摘要、对话式查询、自动标签等。但需注意,其底层仍以人工组织的信息架构为基础,与专为 RAG 设计的引擎在检索精度、多跳推理等维度存在本质差距。选型时应区分”文档存储协作”与”知识推理引擎”两种不同诉求。
四、AI 记忆层赛道
该赛道解决 Agent 的”跨会话失忆”问题,使 AI 应用能够持续积累用户偏好、事实变更与交互历史。
4.1 产品定位与协议
| 产品 | 核心机制 | 开源协议 | 关键指标(约 2026-09) |
|---|---|---|---|
| Zep | 时序上下文图谱,处理事实有效期 | 商业 + 开源层 | SOC2/HIPAA 合规 |
| Mem0 | 三级记忆架构,框架无关接入 | Apache-2.0 | 64K+ Stars,p95 延迟 0.2s |
| Letta | Agent 自主管理记忆块,类操作系统设计 | Apache-2.0 | 23K+ Stars |
| LangMem | 程序记忆改写,深度绑定 LangGraph | LangChain 生态 | 第三方基准 p95 延迟 59.82s |
4.2 能力矩阵对比
| 能力维度 | Zep | Mem0 | Letta | LangMem |
|---|---|---|---|---|
| 时序推理(事实过期处理) | 原生支持 | 部分支持 | 不支持 | 不支持 |
| Agent 自主编辑记忆 | 有限 | 提取/更新 | 核心能力 | 含程序记忆 |
| 框架耦合度 | 中等 | 框架无关 | 运行时耦合 | 强绑 LangGraph |
| 部署选项 | 托管 + 部分自托管 | 托管 + 自托管 | Docker 自托管 | 托管 |
| 合规认证 | SOC2/HIPAA | SOC2/HIPAA/BYOK | 无 | 取决于部署 |
4.3 选择建议
低延迟交互场景(如实时客服)优先评估 Mem0 或 Zep;需要 Agent 自主进化行为逻辑时考虑 Letta;已深度采用 LangChain 技术栈且可接受较高延迟的项目可选 LangMem。医疗、金融等强合规领域,Zep 的认证体系更具说服力。
五、企业 RAG 框架赛道
该赛道将非结构化文档转化为可供大模型引用的结构化知识,支撑问答、摘要、分析等应用场景。
5.1 产品概览
| 产品 | 设计重心 | 协议 | 社区规模(约) |
|---|---|---|---|
| WeKnora | 三模式一体,降低入门门槛 | MIT | — |
| Yuxi(语析) | 全栈智能体平台,沙盒隔离 | MIT | — |
| Dify | 可视化编排,生态广度 | Apache-2.0 衍生 | 154K+ Stars |
| RAGFlow | 文档解析精度,复杂版式还原 | Apache-2.0 | 高 |
| QAnything | 跨语言检索,全离线运行 | AGPL-3.0 | 中 |
5.2 关键能力差异
| 维度 | WeKnora | Yuxi | Dify | RAGFlow | QAnything |
|---|---|---|---|---|---|
| 上手难度 | 最低 | 高 | 低-中 | 中 | 中 |
| 文档解析深度 | 中等 | 中等 | 中等 | 最强(DeepDoc) | 强(中文优化) |
| Agent 编排 | 中等 | 强(沙盒隔离) | 强 | v0.20+ 支持 | 不支持 |
| 代码执行沙盒 | 不支持 | 独有 | 插件 | v0.25+ Agent 沙盒 | 不支持 |
| 私有化部署 | 支持 | 支持 | 支持 | 支持 | 全离线 |
5.3 协议风险提示
QAnything 采用 AGPL-3.0 协议,闭源商用需审慎评估法务风险。WeKnora、Yuxi 的 MIT 协议及 Dify、RAGFlow 的 Apache-2.0 协议对商业应用更为友好。
六、代码图谱细分赛道
针对代码库场景的特殊需求,Graphify 提供差异化方案:基于 tree-sitter 抽象语法树构建确定性知识图谱,无需大模型调用即可将代码库转化为可查询结构,实现 71.5 倍 Token 压缩效率。每条边标注置信度标签(EXTRACTED / INFERRED / AMBIGUOUS),可解释性优于纯向量相似度方案。已与 20 余种 AI 编程助手集成。
局限在于专注代码场景,不适用于通用文档 RAG。
七、跨赛道选型决策树
第一步:区分服务对象
- 知识供”人”阅读整理 → 企业研发管理(ONES)或团队协作文档
- 知识供”AI”检索推理 → 进入第二步
第二步:区分 AI 能力类型
- 需要 Agent 记住用户与事实(有状态交互)→ AI 记忆层(Zep / Mem0 / Letta / LangMem)
- 需要将文档转化为问答/分析能力 → 进入第三步
第三步:区分文档处理侧重
- 快速验证、降低试错成本 → WeKnora
- 可视化工作流与插件扩展 → Dify
- 复杂版式(PDF/表格/多栏)精准解析 → RAGFlow
- Agent 需安全操作文件系统 → Yuxi
- 跨语言、无网络环境运行 → QAnything(注意协议)
- 代码库理解与 Token 优化 → Graphify
八、典型组合方案
| 场景 | 推荐配置 |
|---|---|
| 中大型研发团队全链路管理 | ONES(项目管理 + 知识库 + 测试 + 流水线) |
| 企业 Wiki 叠加 AI 问答 | Confluence / 语雀 + Dify / RAGFlow |
| 有状态 AI 客服/助手 | Mem0(通用)/ Zep(合规时序) |
| 文档问答快速验证 | WeKnora 或 Dify |
| 合同/报告类复杂文档 RAG | RAGFlow |
| 国产大模型 + 私有化 + 宽松协议 | WeKnora / Yuxi 择一 |
九、落地建议
工具选型应避免两个常见误区:一是将 RAG 框架直接当作个人知识管理工具使用,二是期待记忆层产品承担文档问答职能。赛道错配会导致实施成本倍增而效果不达预期。
对于赛道内头部产品的最终抉择,建议以相同数据集运行 POC,量化评估检索准确率、响应延迟、Token 消耗与运维复杂度。开源产品的 Star 数量与版本迭代频率可作为社区活跃度的参考,但不应替代实际业务场景的验证。
数据时效性说明:本文指标截至 2026 年 9 月,具体版本特性与定价请以各产品官方渠道为准。
常见问题
Q1:中小团队是否需要完整的研发管理平台?
取决于协作复杂度与增长预期。若团队规模在 50 人以下且流程简单,轻量工具可能更匹配;若预期快速扩张或需多项目并行治理,早期引入 ONES 等平台可降低后续迁移成本。
Q2:AI 记忆层与 RAG 框架能否互相替代?
不能。记忆层管理的是 Agent 的运行时状态(用户偏好、会话历史、事实变更),RAG 框架管理的是静态文档的知识提取与检索。二者可组合使用:RAG 提供领域知识,记忆层提供交互连续性。
Q3:私有化部署是否必然牺牲功能完整性?
并非绝对。部分产品如 ONES、RAGFlow、Yuxi 的私有化版本与 SaaS 版本功能对齐度较高。需具体确认各产品的版本差异说明,重点关注 AI 模型调用方式(本地部署 vs 云端 API)对功能的影响。
Q4:如何评估文档解析能力的实际水平?
建议准备三类测试样本:扫描版 PDF(考验 OCR)、多栏混排文档(考验版式还原)、嵌套表格(考验结构保留)。以相同样本对比各产品的提取结果与后续问答准确率。
Q5:开源协议的 Copyleft 条款具体影响什么?
AGPL-3.0 等强 Copyleft 协议要求衍生作品同样开源。若将此类产品作为内部基础设施且不对外提供服务,影响有限;若嵌入商业产品对外交付,需法律评估合规路径。